El information gain es el porcentaje de frases de tu página que no aparecen en los resultados que el lector ya ha visto sobre el mismo tema. Google patentó el cálculo en 2022 (US 11.354.342 B2). Los asistentes de IA lo aplican al descartar pasajes repetidos antes de responder. En LLMFY lo medimos frase a frase con la función Information Gain: de cada 100 frases de un artículo, cuántas no están en los diez primeros resultados de Google.
Llevo desde 2007 haciendo SEO. El caso que más veo en las auditorías de contenido: el cliente tiene un artículo bien escrito, con buena estructura y keywords en su sitio, y no rankea. Comparado con los diez primeros resultados, dice lo mismo que ellos con otras palabras: information gain cero. Y desde que ChatGPT, Perplexity y las AI Overviews resumen varias fuentes en una respuesta, un contenido sin información nueva no rankea peor: desaparece de la respuesta.
Qué cubre esta guía:
- Qué es el information gain y de dónde sale (con el número de patente y lo que dice de verdad)
- Cómo se calcula, con la fórmula y los umbrales que usamos en LLMFY
- Por qué la búsqueda con IA lo premia más que el buscador clásico
- 12 formas de aumentarlo, con ejemplos de nichos en español
- Cómo medirlo en tu web, gratis, en cinco minutos
- Los errores que lo hunden y una checklist para revisar antes de publicar
- El análisis de este mismo artículo con Information Gain y Human-First Score, con los cambios que provocó
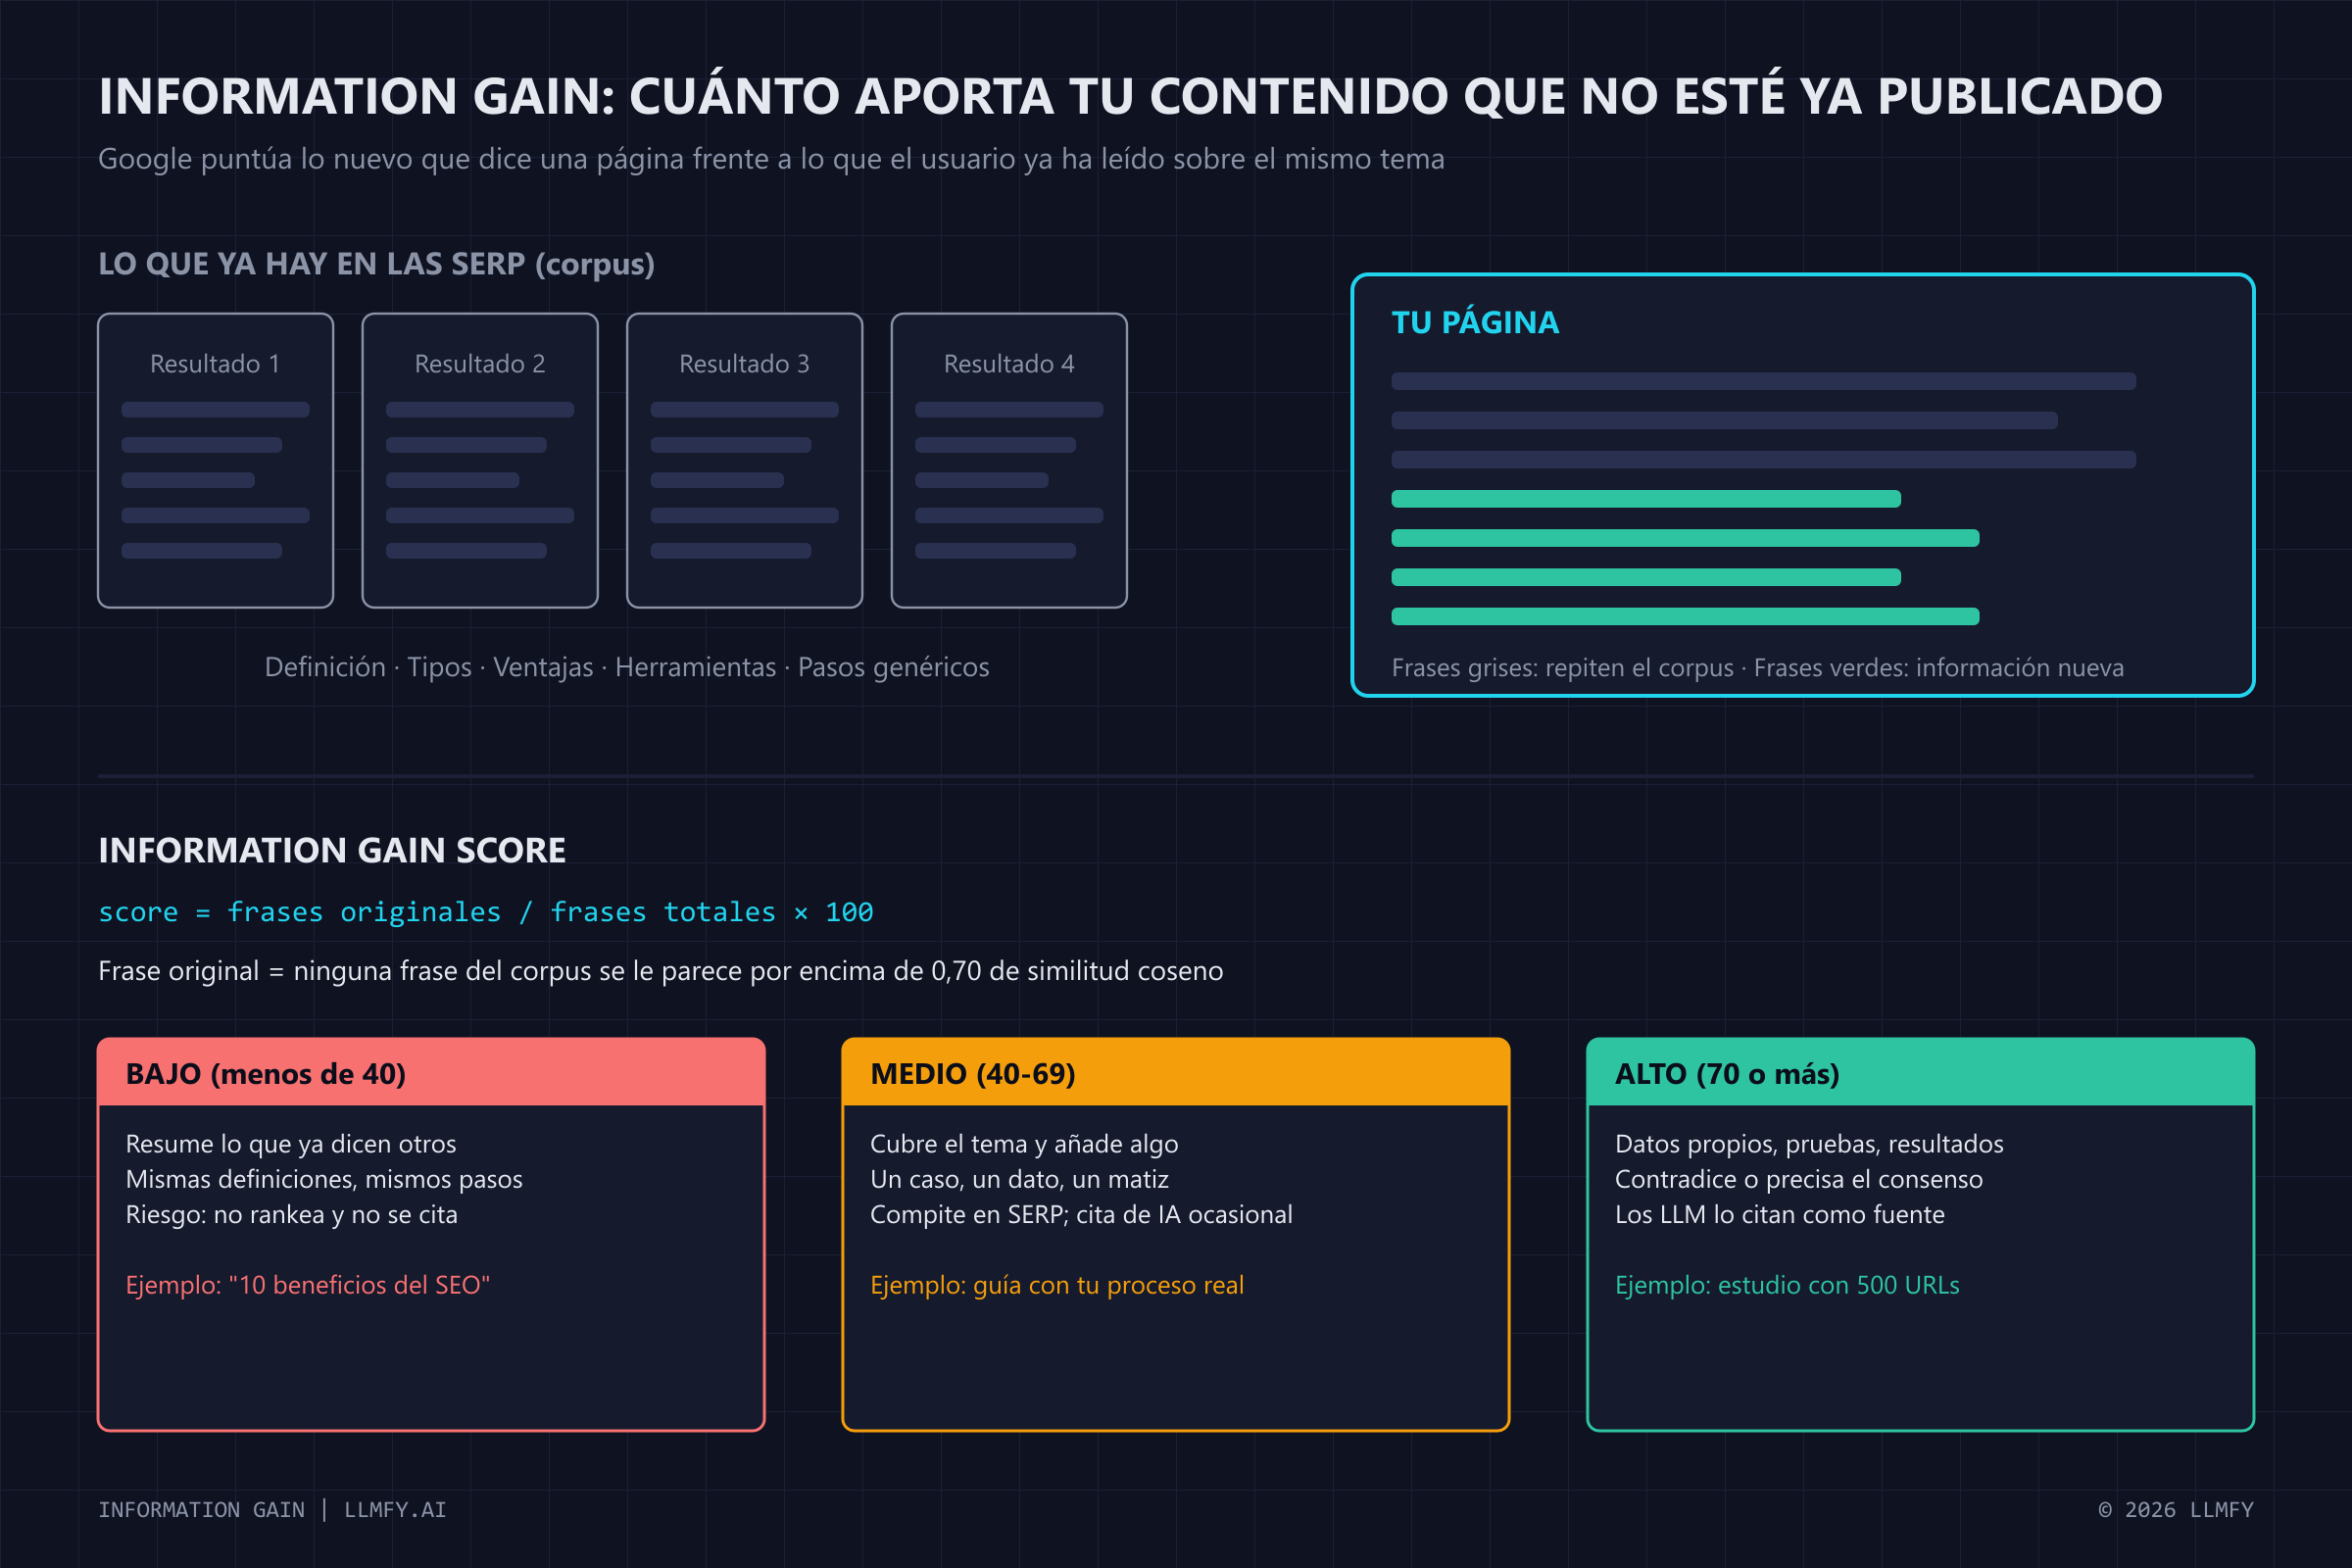
El information gain compara tu página con los diez primeros resultados: solo cuentan las frases que no aparecen en ellos.
Qué es el information gain
En la patente, el information gain (ganancia de información) es un número por documento: cuánto de lo que dice no estaba en los documentos que el usuario ya había consultado sobre ese tema. Si alguien ha leído tres artículos sobre "cómo elegir un seguro de autocaravana" y el cuarto repite las mismas coberturas, los mismos consejos y la misma tabla de precios, su information gain es cercano a cero. Si el cuarto explica qué pasa con la franquicia cuando el vehículo se usa como vivienda habitual, algo que ninguno de los tres anteriores tocaba, su information gain es alto.
Tres matices que las guías del top 10 suelen mezclar (dos de ellas definen el score como "una medida de lo único que es tu contenido"):
- No es contenido único. Un texto puede pasar cualquier detector de plagio y tener information gain cero: basta con parafrasear lo que ya existe. Se calcula sobre embeddings (vectores de significado), no sobre coincidencias de palabras.
- No es longitud. Un artículo de 4.000 palabras que repite el consenso aporta menos que uno de 900 con un dato propio. Google lo dice con otras palabras en su guía de contenido útil: pregunta si el contenido ofrece "información, informes, investigación o análisis originales".
- Depende del corpus. La misma página tiene un information gain alto para una búsqueda y bajo para otra, porque lo que "ya se sabe" depende de qué resultados compiten en cada caso.
De dónde viene el término: entropía y árboles de decisión
Antes de ser un concepto SEO, el information gain es una métrica clásica del aprendizaje automático. En los árboles de decisión mide cuánto reduce la incertidumbre (la entropía) una variable al dividir un conjunto de datos: cuanta más incertidumbre elimina, más ganancia de información aporta. Google aplicó la misma idea a documentos: una página vale más cuanta más incertidumbre elimina para un usuario que ya ha leído otras sobre el tema.
La ganancia se mide contra lo que ya se sabe: publicar lo que todos publican no suma, aunque esté mejor redactado.
La patente de Google: qué dice y qué no dice
La patente que da nombre a todo esto es la US 11.354.342 B2, "Contextual estimation of link information gain", solicitada por Victor Carbune y Pedro Gonnet (Google) el 18 de octubre de 2018 y concedida el 7 de junio de 2022. Se publicó primero como solicitud US 2020/0349181 A1, y Google la ha ido renovando con continuaciones: US 11.720.613 (2023), US 12.013.887 (2024) y US 12.326.889 (junio de 2025). Si una empresa renueva una familia de patentes durante siete años, la idea sigue en uso; lo que no dice la renovación es en qué sistema.
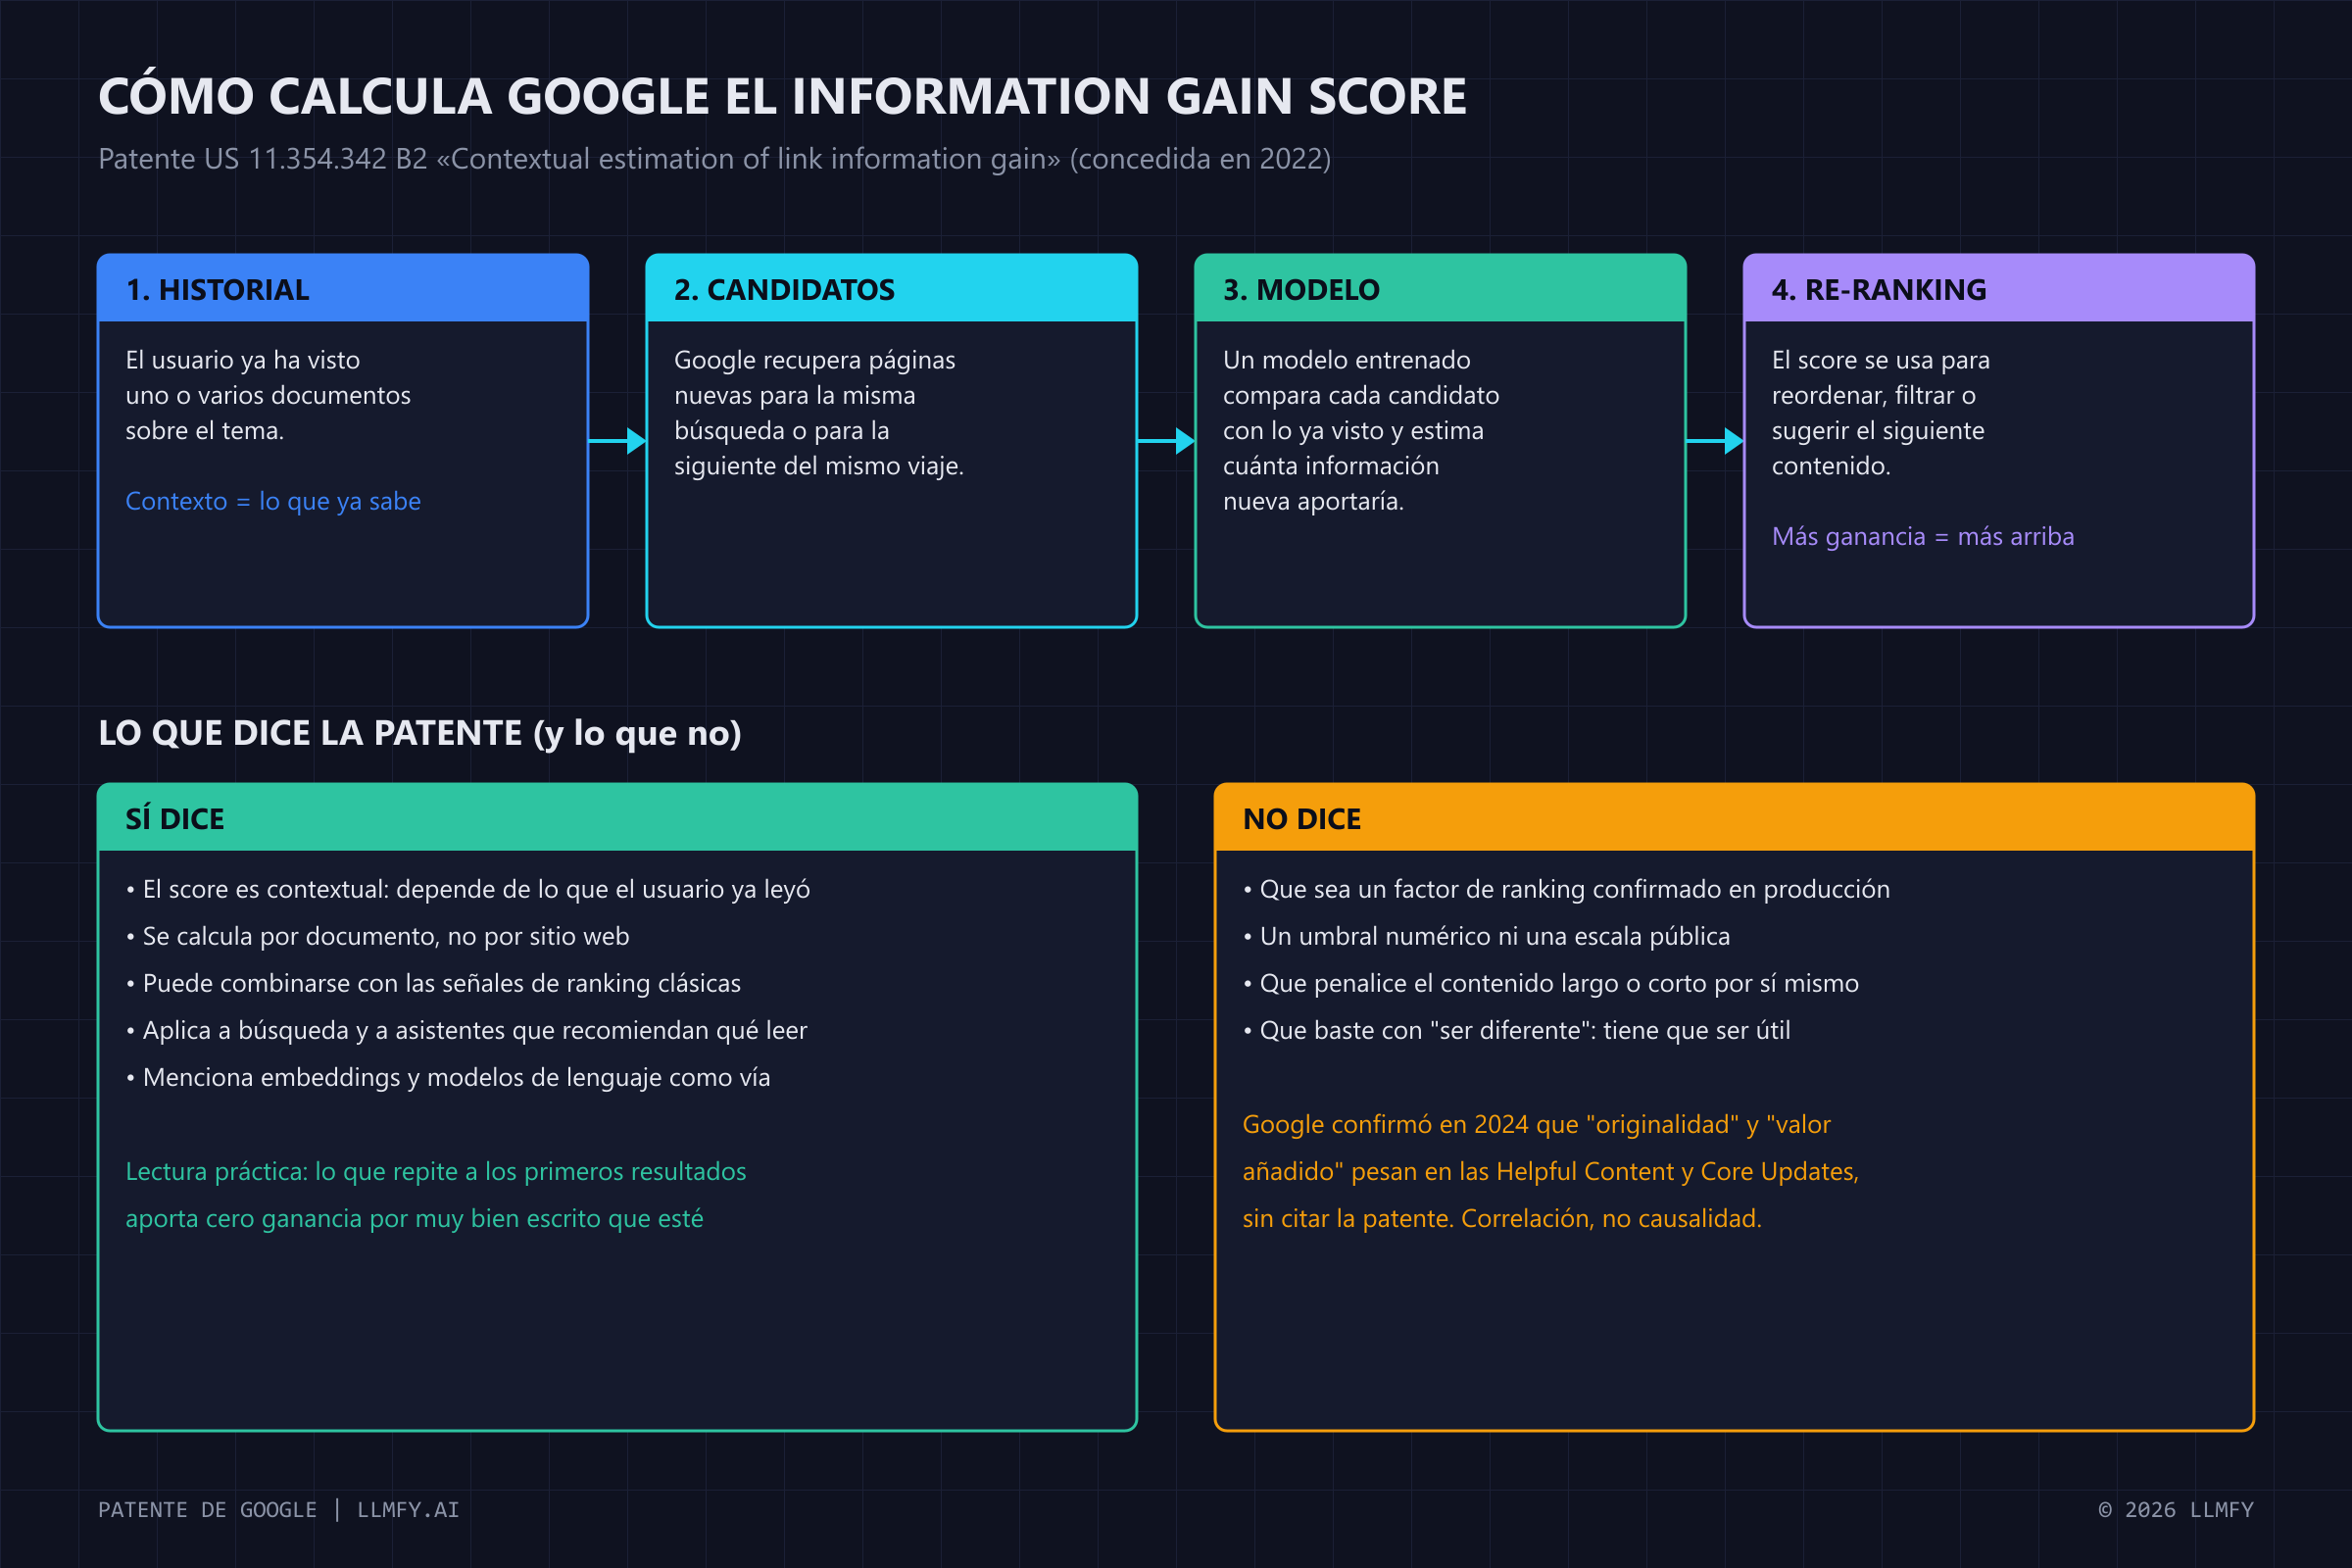
Flujo descrito en la patente US 11.354.342 B2: el score es contextual, se calcula por documento y sirve para reordenar o filtrar resultados.
El resumen de la patente define el score como una puntuación "indicativa de la información adicional incluida en el documento más allá de la información contenida en documentos que el usuario ya ha visto". El mecanismo, simplificado:
- El sistema conoce qué documentos ha consultado el usuario sobre un tema (su contexto).
- Recupera documentos candidatos para la misma consulta o para la siguiente del mismo recorrido.
- Un modelo entrenado compara cada candidato con lo ya visto y estima cuánta información nueva aportaría. La patente habla de representar los documentos como vectores (embeddings) y de modelos de lenguaje para hacer esa comparación.
- El score se usa para reordenar, filtrar o recomendar el siguiente contenido, y puede combinarse con las señales de ranking habituales.
- El caso de uso que más detalla la patente es el de los resultados secundarios: si el usuario vuelve al buscador porque los primeros resultados no le han bastado, el sistema puede priorizar documentos con más información nueva en lugar de repetirle los que ya ha visto. La patente también describe lo contrario: recomendar contenido con score bajo cuando el usuario quiere reforzar algo que ya sabe.
Lo que la patente no dice, y que se repite como si lo dijera:
- No confirma que sea un factor de ranking activo en el buscador. Es una descripción de un sistema, y Google no ha dicho nunca públicamente que lo aplique tal cual.
- No da umbrales ni una escala. El "information gain score" de 0 a 100 que verás en herramientas (incluida la nuestra) es una implementación propia de cada una.
- No premia lo distinto por ser distinto. El texto de la patente habla de información adicional para el usuario, no de originalidad estilística.
Lo que sí sabemos por otras vías: la documentación de Google sobre contenido útil pregunta explícitamente por "información, informes, investigación o análisis originales" y por si el contenido "aporta valor sustancial en comparación con otras páginas de los resultados". Y en la filtración de la documentación interna de Content Warehouse de mayo de 2024 aparece un atributo llamado OriginalContentScore, aplicado a contenidos cortos. Google lleva desde 2018 registrando formas de medir lo que una página añade, y la patente de information gain es la única de ellas que describe el cálculo paso a paso.
Cómo se calcula el information gain, con números
Nadie fuera de Google conoce su implementación, pero el planteamiento de la patente se puede reproducir con herramientas públicas, y es lo que hicimos al construir la función Information Gain de LLMFY. El método, frase a frase:
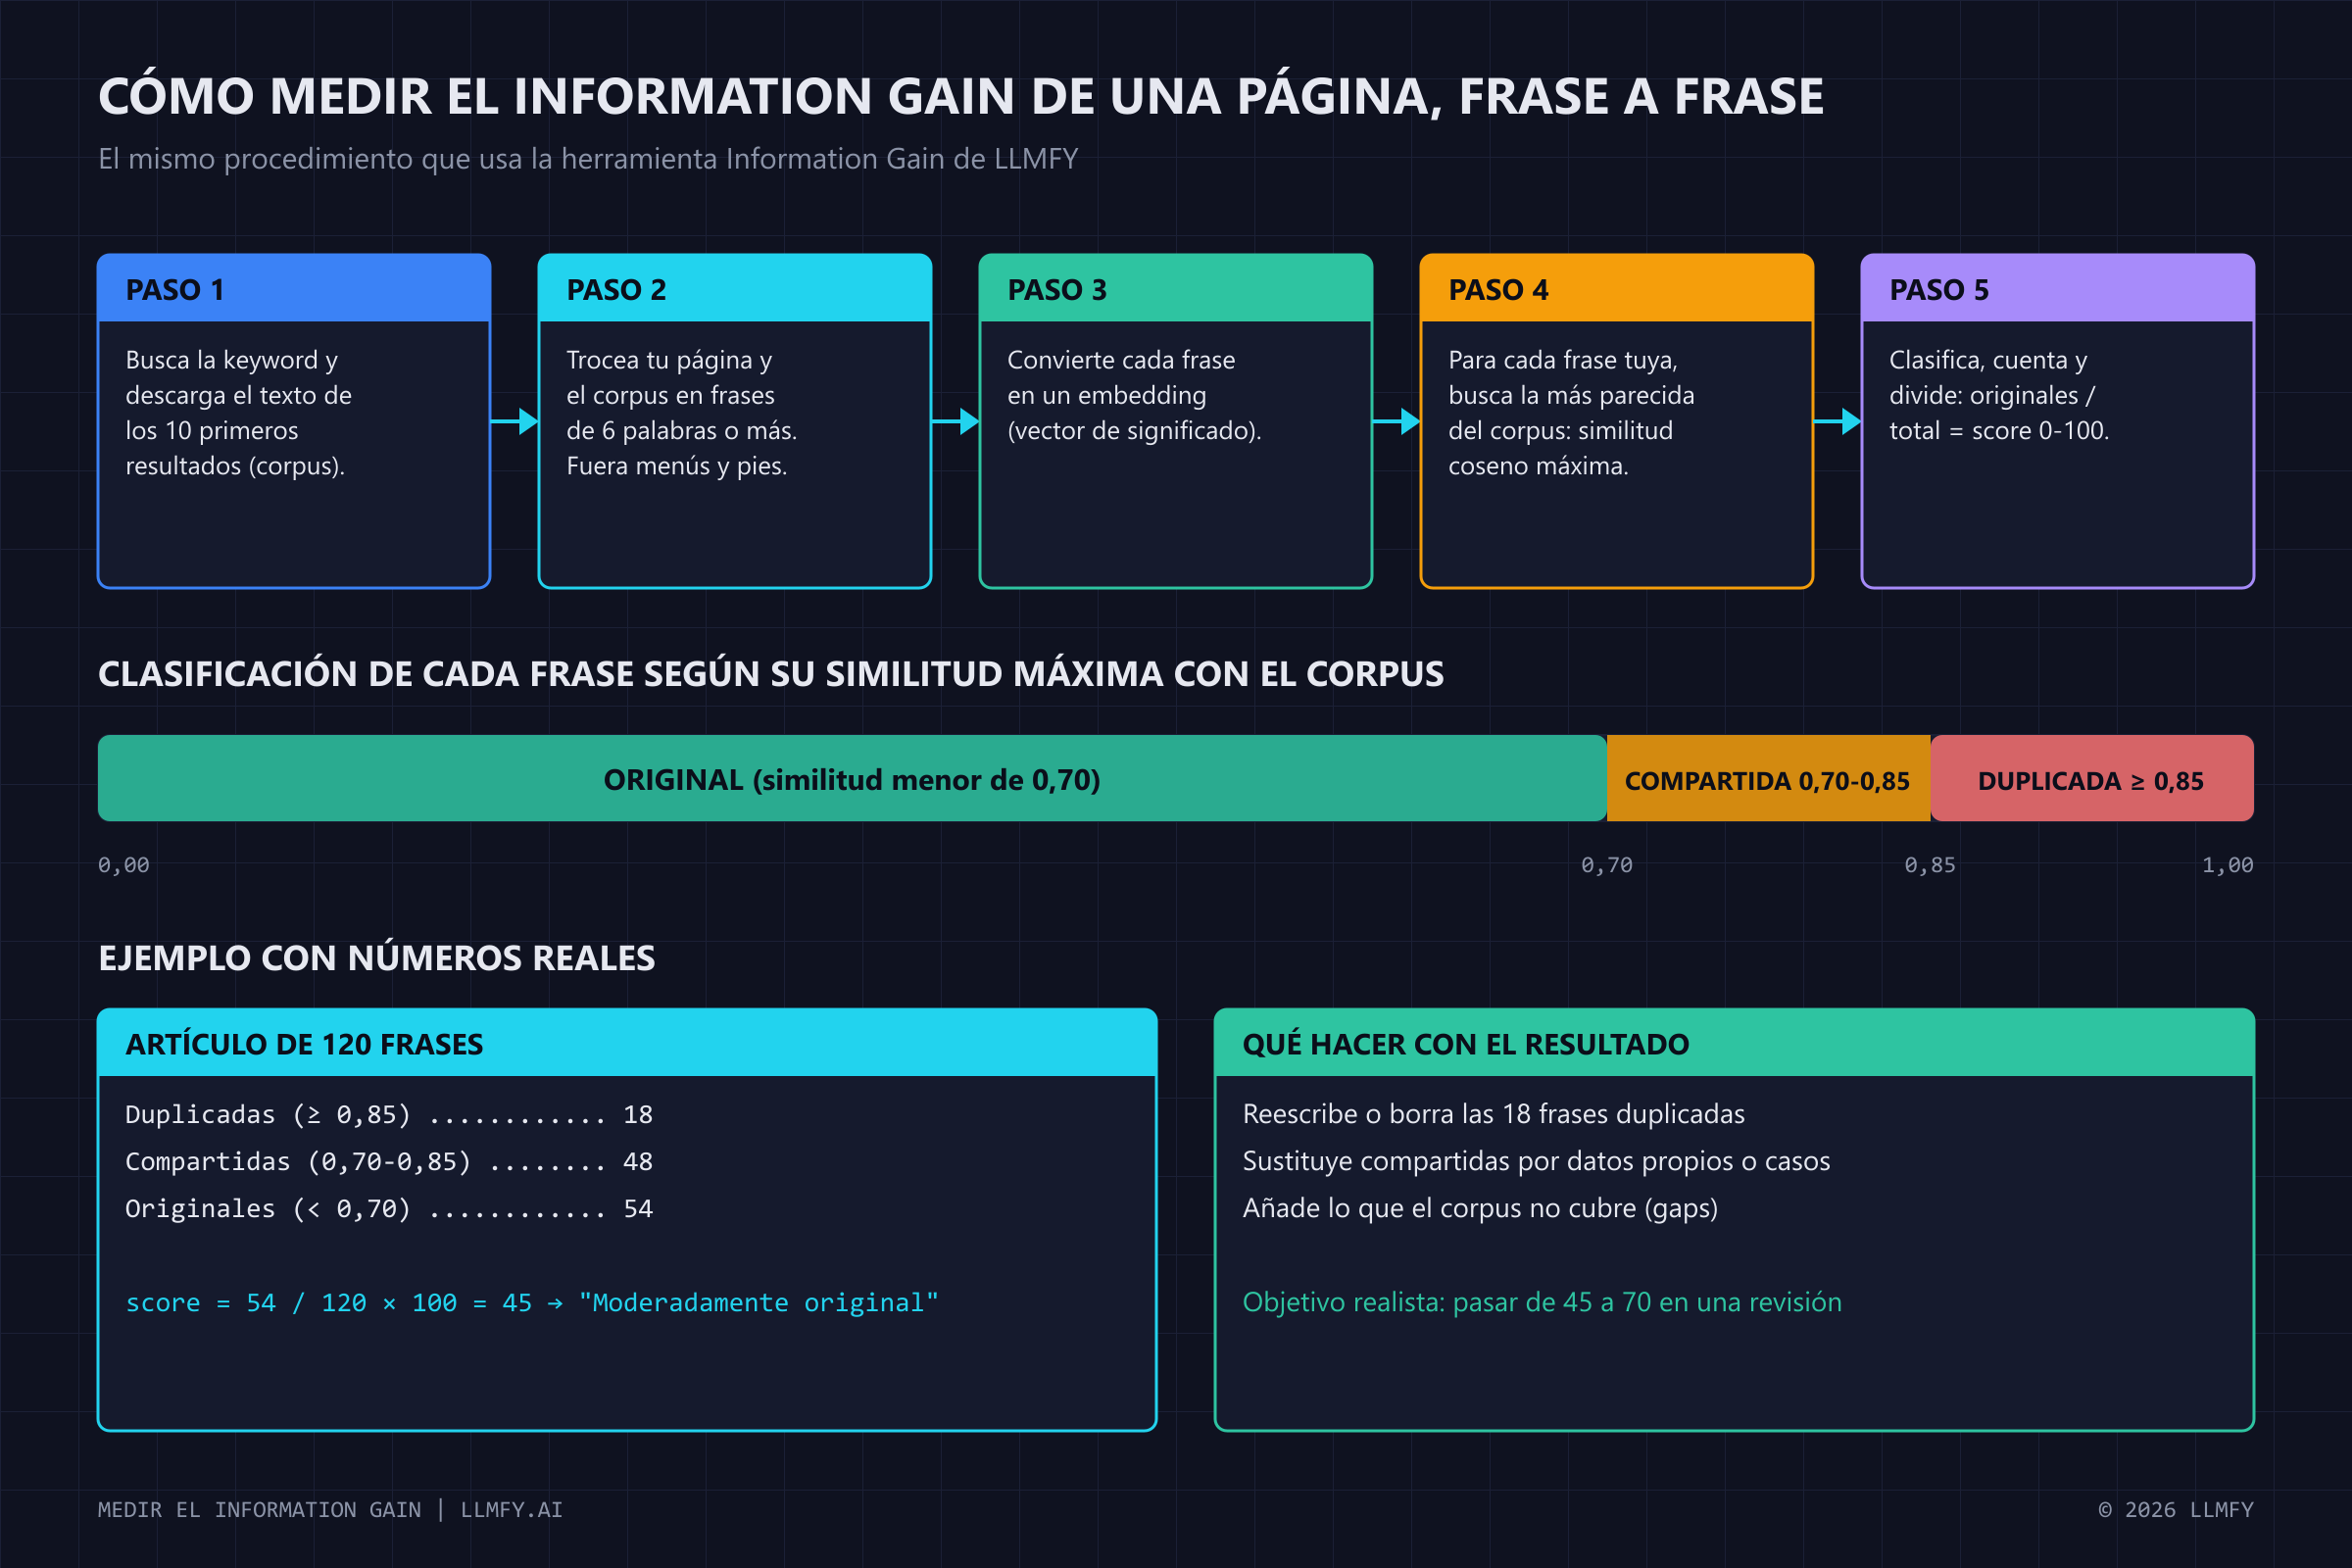
Cada frase de tu página se compara con todas las del corpus de competidores; el score es el porcentaje de frases originales.
- Corpus. Se buscan los diez primeros resultados de la keyword y se extrae su texto principal (sin menús, pies ni cookies).
- Segmentación. Tu página y el corpus se trocean en frases. Las de menos de seis palabras se descartan: son títulos de menú, botones y ruido.
- Embeddings. Cada frase se convierte en un vector de significado con un modelo de embeddings (nosotros usamos el de OpenAI; cualquier modelo multilingüe sirve).
- Similitud máxima. Para cada frase tuya se busca la frase del corpus más parecida y se anota su similitud coseno (de 0 a 1).
- Clasificación y score. Cada frase se etiqueta según esa similitud máxima y el score es el porcentaje de frases originales.
Los umbrales que usamos, validados con SERP reales en español:
| Similitud máxima con el corpus | Clasificación | Qué significa |
|---|---|---|
| 0,85 o más | Duplicada | La frase existe casi igual en otro resultado |
| Entre 0,70 y 0,85 | Compartida | Mismo tema y misma idea, redacción distinta |
| Menos de 0,70 | Original | Nadie del corpus dice eso |
La fórmula es deliberadamente simple: score = frases originales / frases totales × 100. A partir de 70 lo consideramos muy original; entre 40 y 69, moderadamente original; por debajo de 40, mayoritariamente compartido. Los umbrales son los mismos en todos los nichos; lo que cambia es el corpus: en una búsqueda local o muy técnica el top 10 es pobre y pasar de 70 cuesta poco, y en un nicho saturado como el SEO en inglés cada definición o consejo ya está escrito diez veces, así que un 60 ahí vale más que un 85 en una keyword local.
Un ejemplo con cifras reales de un análisis: artículo de 120 frases, 18 duplicadas, 48 compartidas y 54 originales. Score 45, "moderadamente original". La utilidad está en la lista: las 18 frases duplicadas son las primeras candidatas a borrar o reescribir, y las 48 compartidas, el sitio donde meter datos propios. En una sola revisión ese mismo artículo pasó a 71.
Para que tengas una referencia de escala: en los 25 análisis completados con la herramienta entre el 17 de junio y el 8 de septiembre de 2026, la mediana del score fue 85, 19 de los 25 superaron 70 y solo uno quedó por debajo de 40. No es una muestra representativa de la web (son en su mayoría contenidos ya trabajados por quien decide medirlos), pero sí demuestra que pasar de 70 es un objetivo alcanzable con una revisión seria.
Tres límites del método:
- Las definiciones siempre salen compartidas. Si escribes sobre information gain, la frase "el information gain mide cuánta información nueva aporta un contenido" la tienen los diez resultados. No pasa nada: hace falta para el lector que llega frío. El problema empieza cuando el 60 % del artículo son frases así.
- Original no es sinónimo de bueno. Una frase sin sentido también puntúa como original. El score mide novedad; la utilidad la tienes que poner tú.
- Solo mide texto. Un vídeo, un podcast o una infografía no entran en la comparación frase a frase. Lo que sí entra es lo que los acompaña: la transcripción, el texto alternativo, la tabla con los datos del gráfico. Si tu ganancia está en un formato visual, escríbela también.
Information gain y relevancia semántica: dos medidas que se complementan
Conviene no confundir el information gain con la relevancia semántica, que es la otra cara del análisis. La relevancia mide cuánto se parece tu página al tema que busca el usuario (y a lo que cubren los competidores); el information gain mide cuánto añades a ese tema. Una página puede ser muy relevante y aportar cero (repite el consenso), o aportar mucho y ser poco relevante (habla de otra cosa). Ranking y citas dependen de las dos: cobertura de la intención (relevancia semántica) e información que nadie más tiene (information gain). Por eso en LLMFY las dos funciones van juntas: AIO Semántico mide la cobertura y la similitud frente a los competidores por embeddings, e Information Gain mide lo que aportas sobre ese mismo corpus. Si quieres profundizar en la primera, tienes la guía de SEO semántico.
¿Basta con information gain si mi sitio no tiene autoridad en el tema?
No. Una página muy original en un tema donde el dominio no tiene historial rankea peor que la misma página en un dominio con autoridad temática; lo vemos cada vez que un cliente abre una sección nueva. Lo que cambia con el information gain es el orden de los factores: sin él, la autoridad te coloca en la primera página y la IA te ignora igualmente al deduplicar; con él, un dominio pequeño puede conseguir citas en ChatGPT o Perplexity antes de conseguir posiciones en Google, porque la deduplicación de pasajes no mira la autoridad del dominio, mira el contenido del pasaje. Es la vía de entrada más realista para un sitio nuevo: publicar el dato que nadie tiene, conseguir la cita y, con ella, la mención y el enlace que construyen la autoridad.
Por qué la búsqueda con IA lo premia más que Google
En el buscador clásico, un resultado repetido cuesta poco: el usuario lo ve, lo salta y sigue. En una respuesta generada, cada pasaje que el modelo incorpora ocupa espacio en su ventana de contexto y en la respuesta final. Por eso los sistemas de generación aumentada por recuperación (RAG) deduplican antes de redactar: si diez pasajes dicen lo mismo, con uno basta.
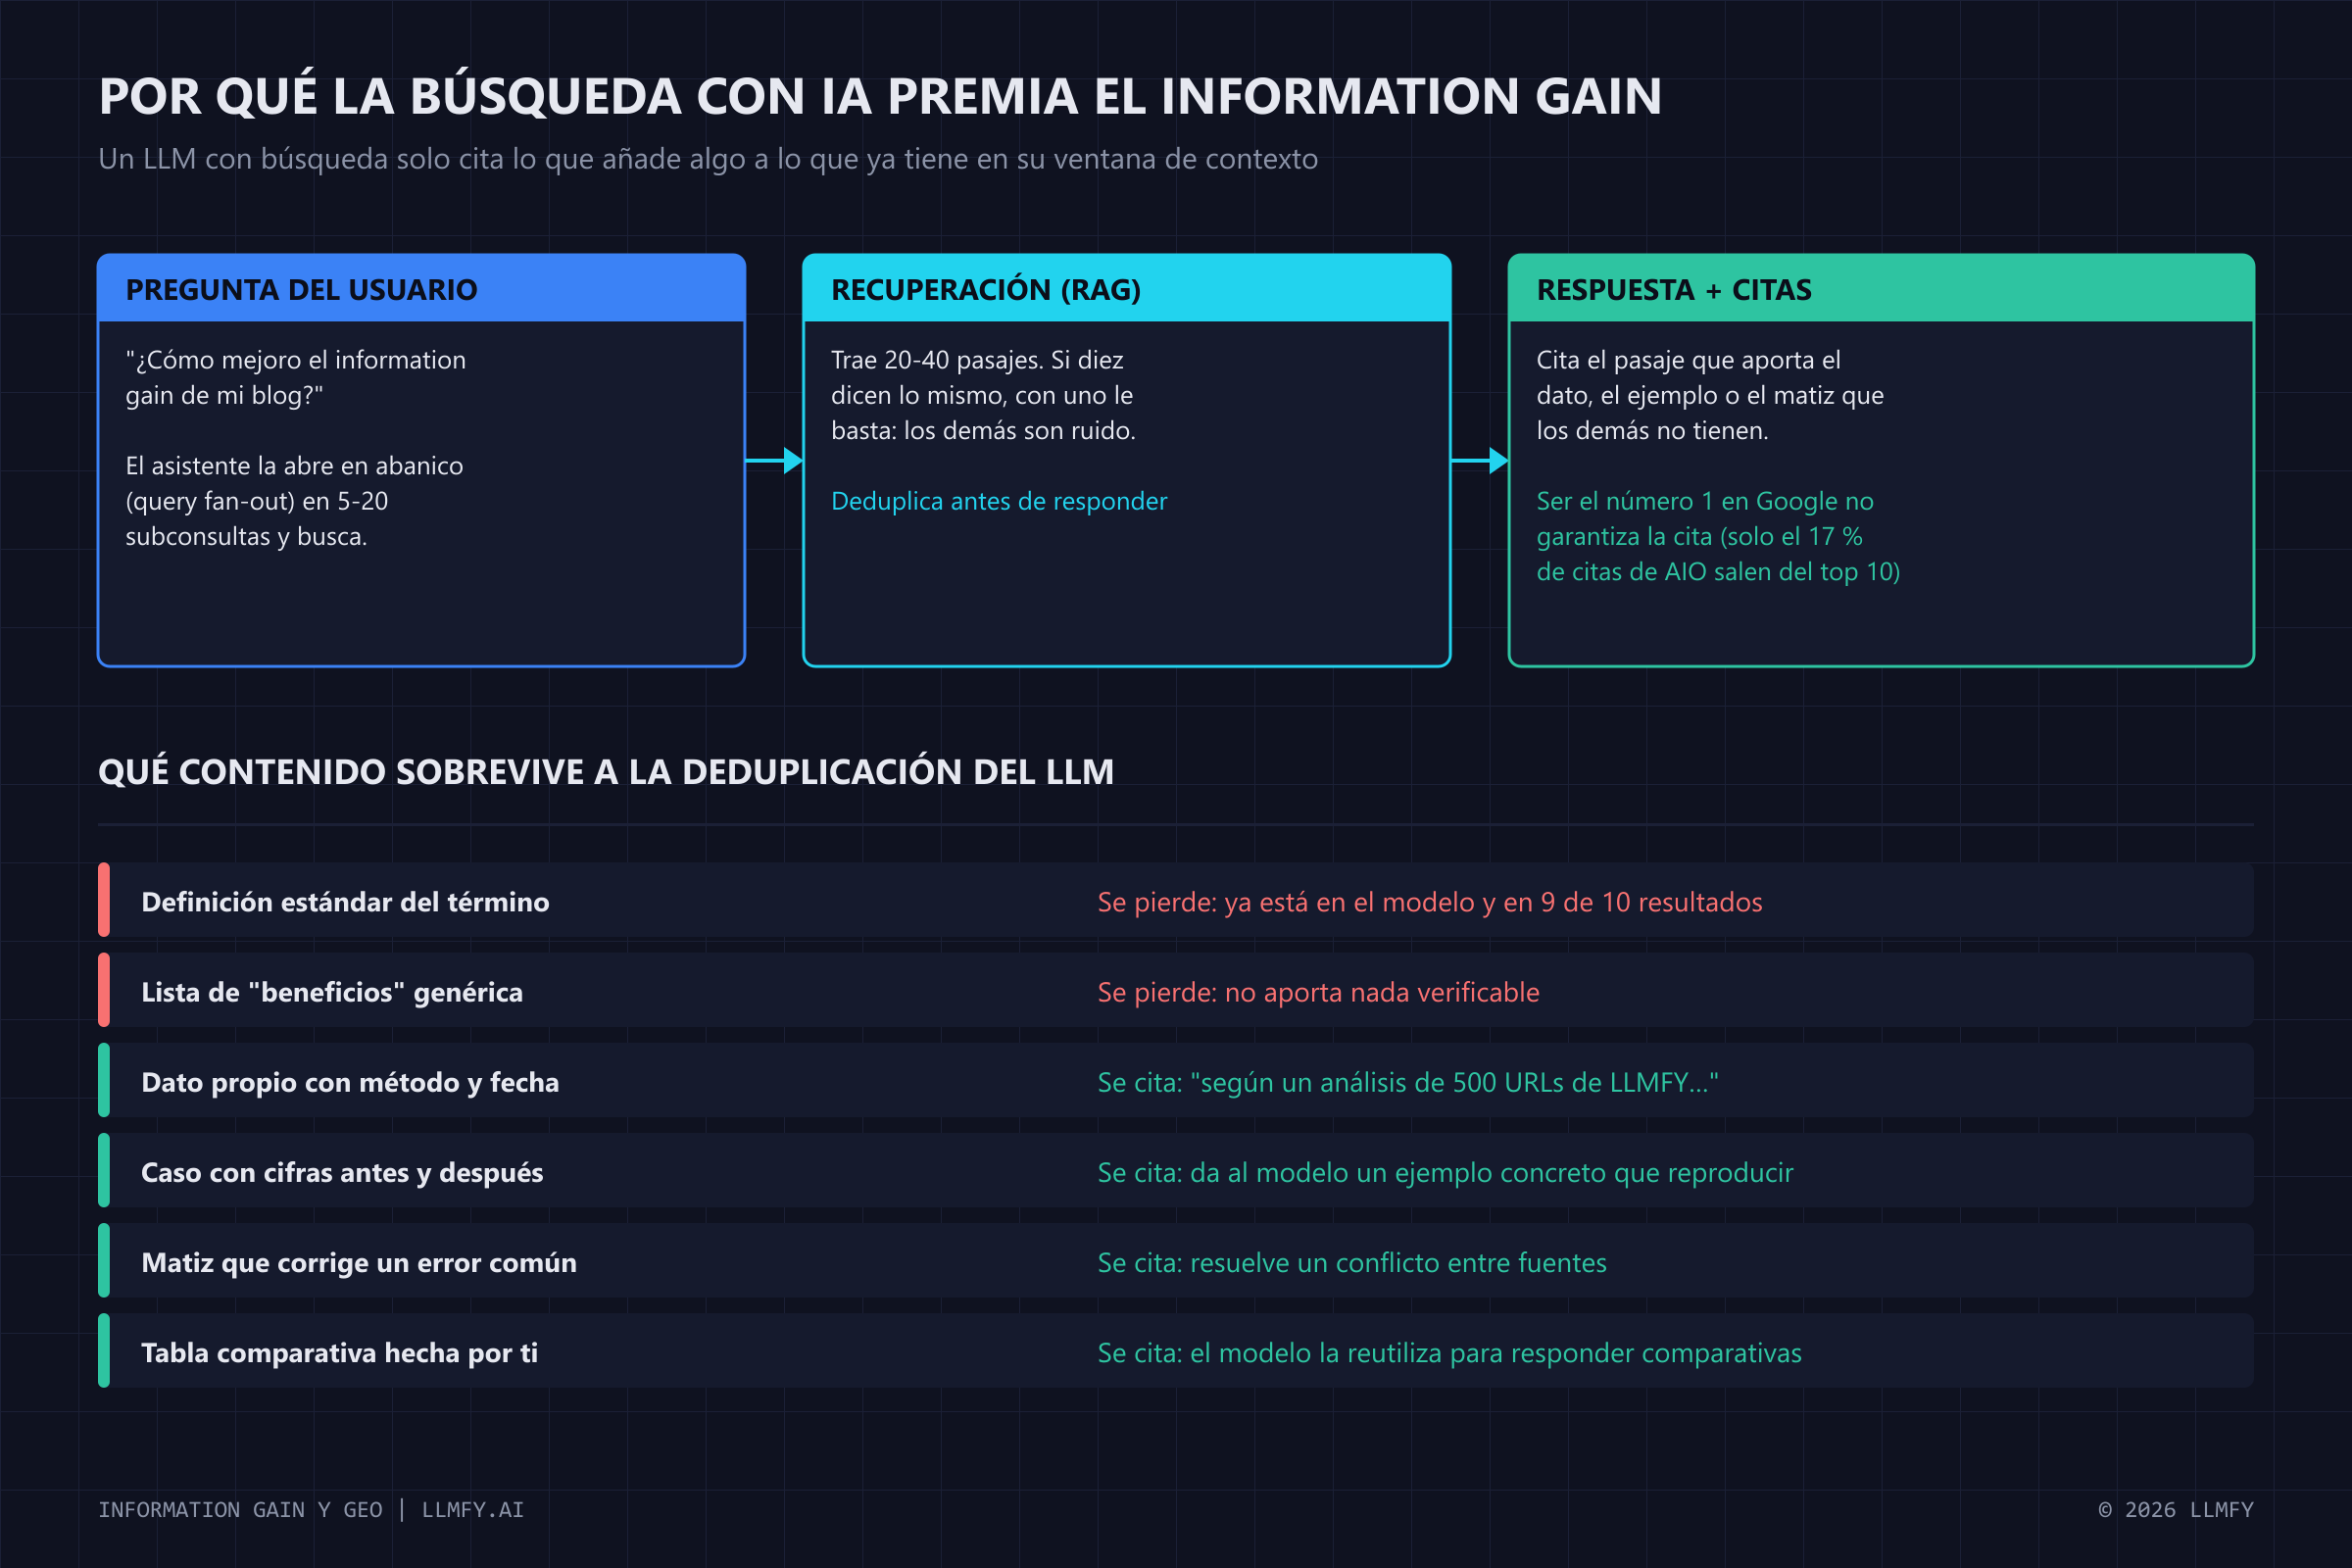
Un asistente con búsqueda deduplica los pasajes antes de responder: sobrevive el que aporta el dato, el ejemplo o el matiz.
El proceso, tal como lo vemos en los registros de citación que analizamos en LLMFY:
- La pregunta del usuario se abre en abanico (query fan-out) en varias subconsultas.
- El sistema recupera decenas de pasajes, no páginas enteras.
- Descarta los redundantes y se queda con los que cubren algo distinto: un dato, un ejemplo con cifras, una excepción, una comparativa.
- Redacta y cita las fuentes de esos pasajes.
Esos mismos registros muestran la consecuencia: ser el primero en Google ya no garantiza la cita. BrightEdge, tras 16 meses siguiendo AI Overviews, encontró que solo el 17 % de las citas salían del top 10 orgánico. Y en nuestras propias auditorías GEO, donde comprobamos qué URL citan ChatGPT, Gemini, Perplexity y Claude para un mismo conjunto de prompts, vemos con frecuencia páginas en posición 1 de Google sin una sola cita mientras un resultado de la segunda página se lleva cuatro de cinco. Cuando abrimos las dos, la diferencia casi siempre es la misma: la segunda tiene algo que la primera no tiene.
Hay además una investigación reciente de Google que encaja aquí. En 2025, un equipo de Google Research publicó el concepto de "contexto suficiente" (sufficient context) para sistemas RAG: el modelo evalúa si los pasajes recuperados bastan para responder, y su comportamiento cambia según eso. Un pasaje que repite lo que otros ya aportan no añade suficiencia; uno que cierra un hueco, sí.
Y un tercer dato, este del estudio de Princeton sobre optimización para motores generativos (Aggarwal y otros, KDD 2024): añadir citas a fuentes, estadísticas y citas textuales de expertos aumentó la visibilidad del contenido en respuestas generadas entre un 28 % y un 41 % según la táctica. Son exactamente los tres ingredientes que más suben el information gain.
¿Y en las métricas de comportamiento: CTR, permanencia, conversión?
Aquí toca ser honesto: no tenemos un estudio propio que aísle el efecto del information gain sobre el CTR o el tiempo en página, y desconfía de quien te lo venda, porque separar ese efecto del cambio de posición es casi imposible. Lo que sí puedes medir tú, y es lo que hacemos en las revisiones de contenido: anota en Search Console el CTR de la URL a posición estable durante las cuatro semanas anteriores a la revisión, sube el score de information gain sin tocar título ni descripción, y compara el CTR a la misma posición cuatro semanas después. Si el título no cambia, la diferencia de CTR a igual posición es ruido; lo que cambia con la ganancia de información es la permanencia y, sobre todo, las citas en asistentes, que Search Console no ve y que hay que seguir aparte.
Information gain y E-E-A-T: la misma moneda
Google evalúa Experiencia, Conocimiento, Autoridad y Confianza (E-E-A-T). La primera E, experiencia de primera mano, es information gain por definición: si has hecho lo que cuentas, tienes datos, capturas, errores y resultados que nadie más puede tener.
Cuando pasamos la misma URL por la auditoría E-E-A-T y por Information Gain, las que suspenden en experiencia son las que describen un proceso "en general", sin haberlo hecho, y esas mismas páginas puntúan bajo en ganancia de información: no hay nada propio que contar. Un artículo de peluquería que explica "cómo hacer un degradado" a partir de otros artículos tiene un problema de E-E-A-T y de information gain al mismo tiempo; el de la peluquería que graba el corte, cuenta cuánto tarda y qué máquina usa, resuelve los dos.
12 formas de aumentar el information gain de un artículo
Van de mayor a menor impacto en el score: las primeras lo mueven decenas de puntos, las últimas unos pocos y son las más fáciles.
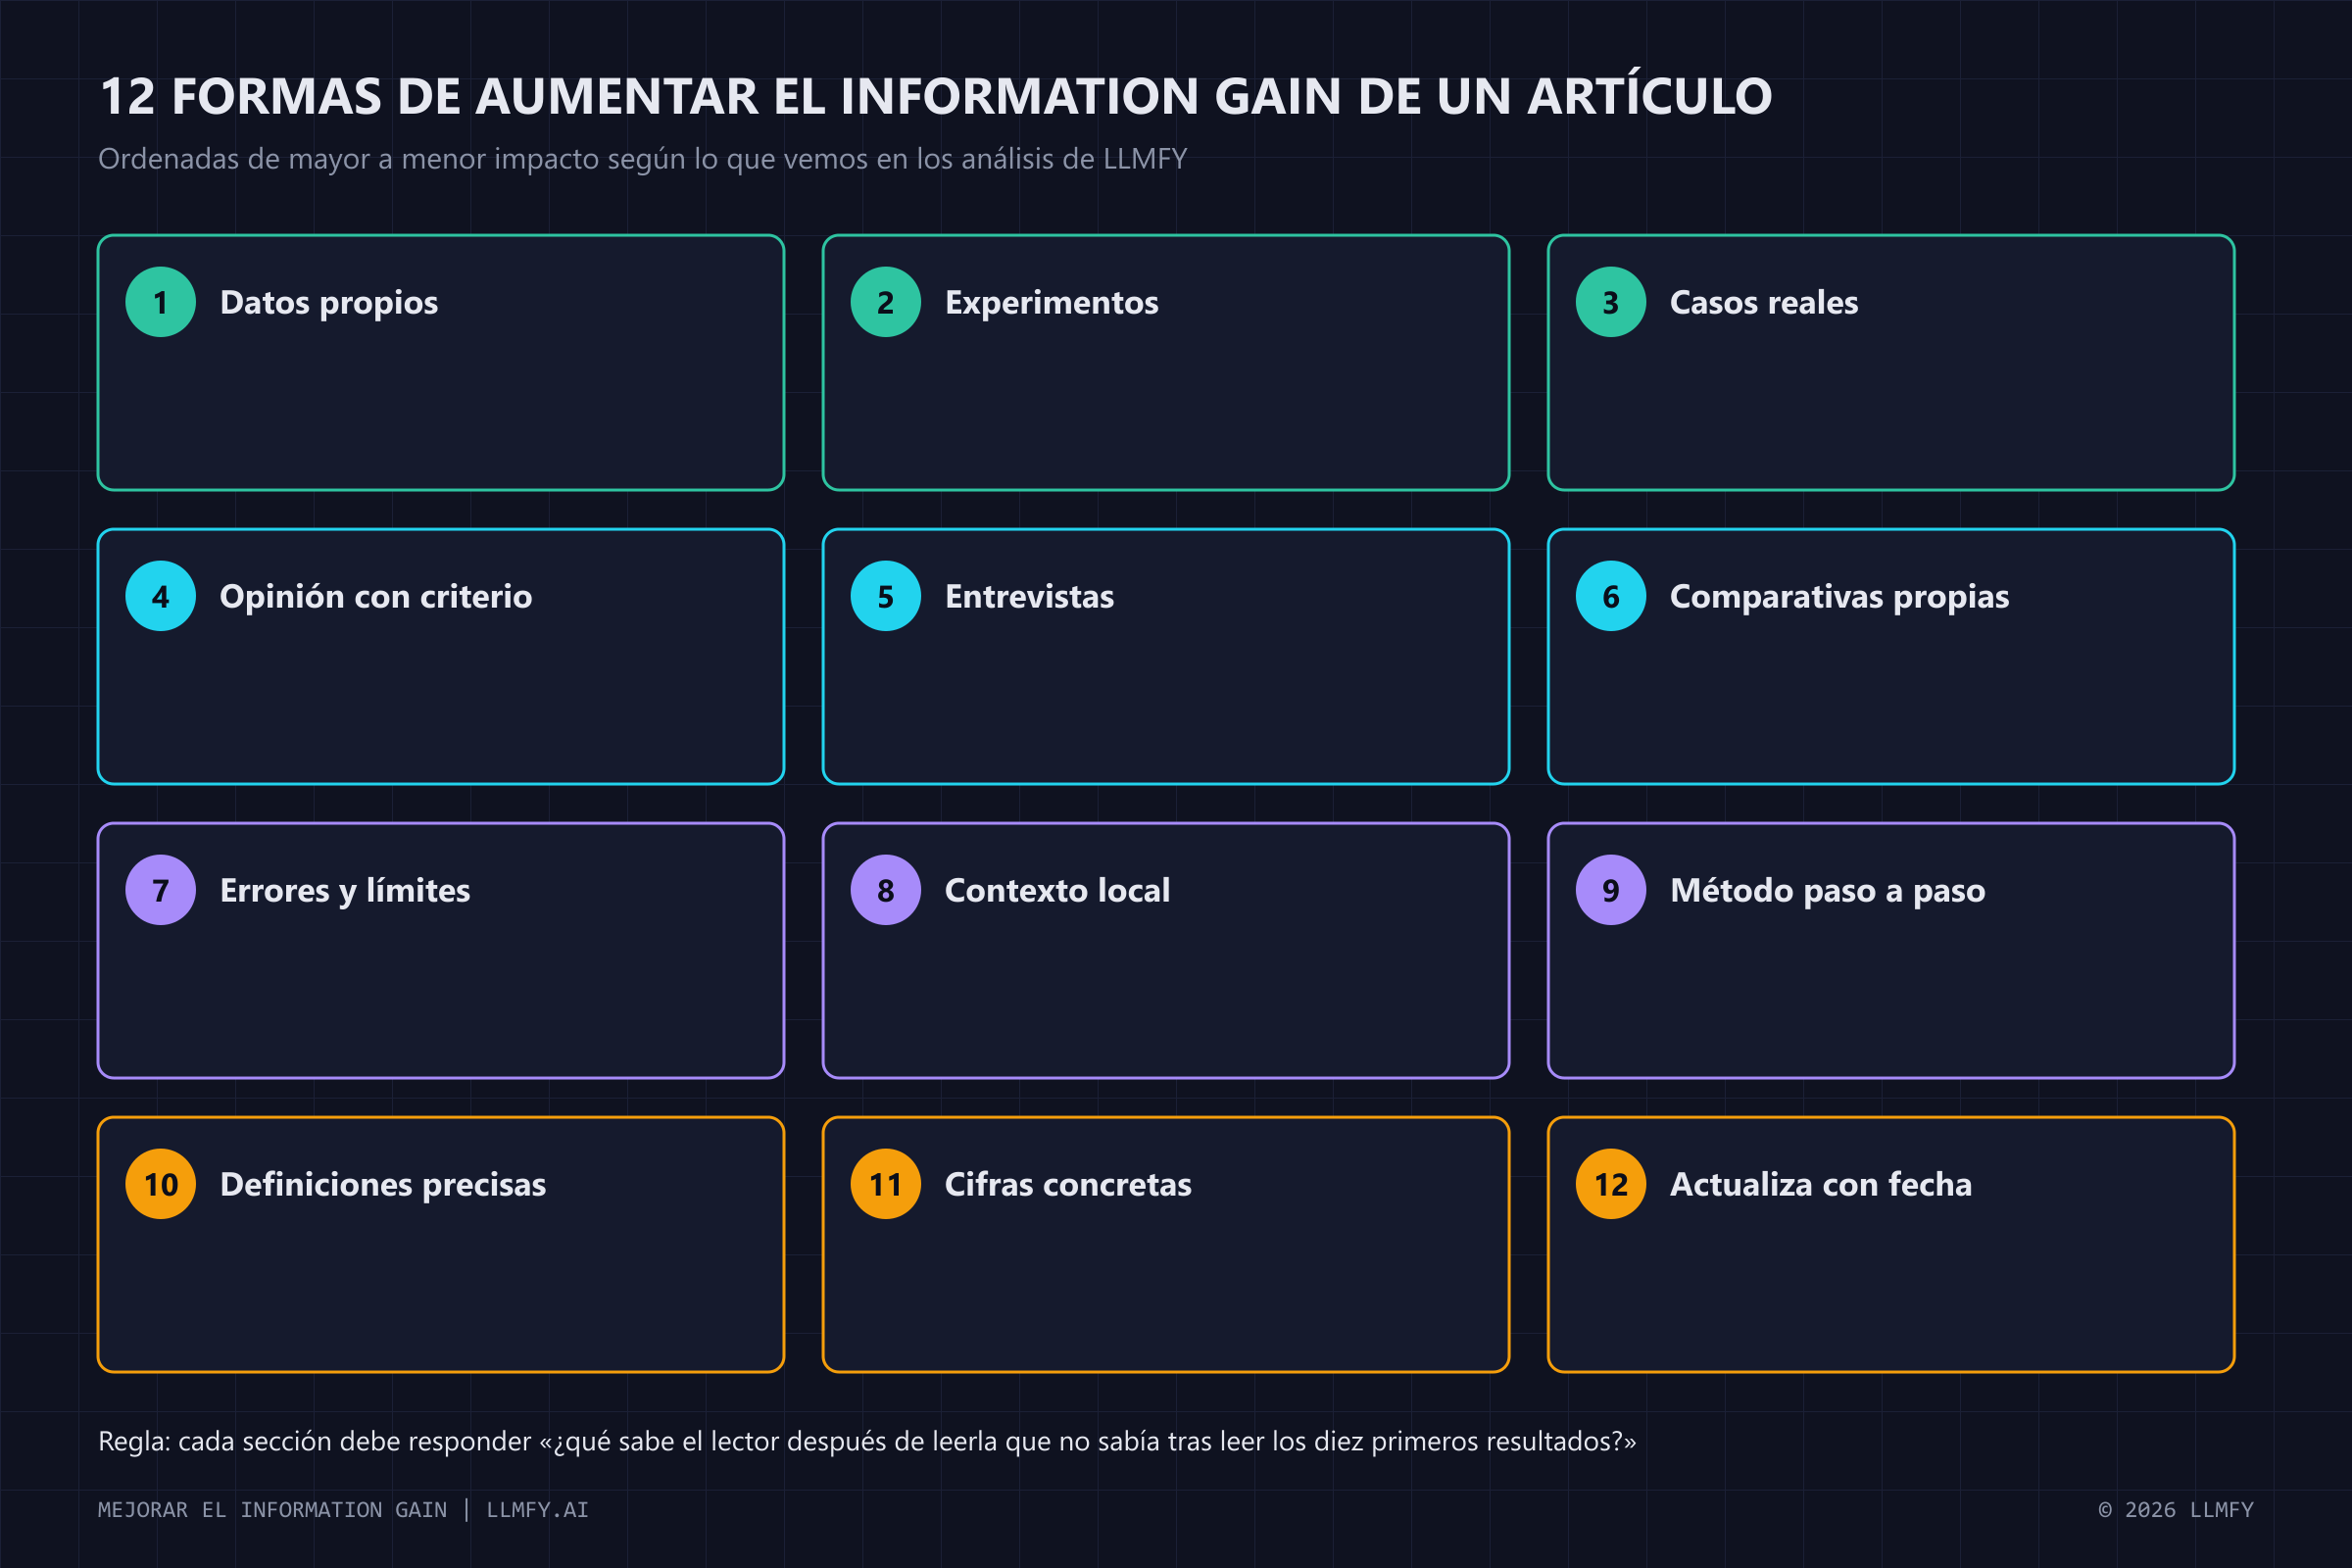
Cada sección debe aportar algo que el lector no sabía tras leer los diez primeros resultados; las tácticas van de mayor a menor impacto.
1. Datos propios
Es la táctica de mayor rendimiento y la que menos gente aplica. No hace falta un estudio con miles de encuestados: sirve cualquier dato que solo tú puedas producir. Una tienda de perfumes sin alcohol puede publicar qué porcentaje de sus pedidos son de clientes que repiten y a qué países envía; una correduría de seguros, el precio medio real de las pólizas que ha emitido este año por tipo de vehículo. Ese párrafo no existe en ningún otro sitio de internet, y por eso los modelos lo citan.
2. Experimentos
Prueba algo y publica el resultado, salga bien o mal. "Cambiamos la política de devoluciones de 14 a 30 días en marzo y las devoluciones subieron un 2 % mientras la conversión subió un 11 %" vale más que diez párrafos de teoría sobre confianza del consumidor.
3. Casos reales con cifras
Antes, después y qué falló por el camino. El "qué falló" es la parte que casi nadie escribe y la que más ganancia aporta, porque el corpus está lleno de casos de éxito idénticos.
4. Opinión con criterio
Discrepar del consenso, con argumentos, es information gain puro: por definición, lo que dices no está en el corpus. Un ejemplo de este mismo artículo: la mayoría de guías tratan la patente de 2022 como confirmación de un factor de ranking, y en mi lectura no lo es. Puedes no estar de acuerdo; el punto es que el lector sale con una idea que no tenía.
5. Entrevistas y citas textuales
Preguntar a quien hace el trabajo cada día y citarlo textualmente. En el estudio de Princeton, las citas textuales fueron la táctica con mayor efecto en la visibilidad generativa. Una frase entrecomillada de un instalador de suelos sobre por qué falla la junta en cocinas aporta más que tres párrafos redactados desde un escritorio.
6. Comparativas propias
Una tabla que hayas construido probando los productos o servicios, no copiada de las fichas del fabricante. Las comparativas son de los contenidos que más reutilizan los modelos al responder preguntas del tipo "X o Y".
7. Errores, límites y cuándo no funciona
Casi todo el corpus explica cuándo usar algo; casi nadie explica cuándo no. Una sección de "esto no te sirve si..." es un hueco abierto en la mayoría de SERP.
8. Contexto local
Precios, normativa, plazos y proveedores de tu país o sector. La mayoría del contenido en español sobre temas técnicos es traducción de fuentes en inglés con contexto estadounidense. Añadir el dato local es ganancia inmediata y, además, es lo que el usuario en España o en Latinoamérica necesita.
9. Método paso a paso con tus capturas
Tu proceso exacto, con capturas de tus herramientas y tus plantillas. Un proceso genérico es compartido; el tuyo, con los pasos en los que te has equivocado, es original.
10. Definiciones precisas que corrigen confusiones
Cuando el corpus mezcla dos conceptos (information gain y contenido único, por ejemplo), aclararlo con precisión aporta información nueva aunque el tema sea el mismo.
11. Cifras concretas en lugar de adjetivos
Sustituye "muchos", "rápido" y "significativo" por 37 %, 1,8 segundos y 12 puntos. Es la táctica más barata: no exige investigar nada nuevo, solo medir lo que ya haces.
12. Actualiza con fecha y explica qué cambió
Un artículo actualizado que dice qué ha cambiado desde la versión anterior, y por qué, aporta más que uno reescrito para parecer nuevo. La ganancia de información caduca por un mecanismo medible: cuando un competidor incorpora tu dato, la similitud máxima de esa frase con el corpus sube por encima de 0,70 y pasa de original a compartida sin que tú hayas tocado nada. En los contenidos que seguimos, un dato propio publicado en un nicho SEO tarda entre tres y doce meses en aparecer en otros artículos; en nichos locales o muy técnicos, más de un año. Por eso conviene revisar los contenidos importantes al menos una vez al año midiendo el score antes y después, y con más frecuencia si aparecen competidores nuevos en la SERP. Y si sospechas que un competidor rellena con texto de IA, pásalo por el Human-First Score: un competidor que genera sin datos propios baja el listón del corpus, y es la señal de que un dato tuyo bien puesto te distancia con poco esfuerzo.
Y fuera del blog: fichas de producto, servicios locales y cola larga
Todo lo anterior vale para contenido editorial, pero el information gain rinde igual o más donde casi nadie lo aplica:
- Fichas de producto. Las descripciones del fabricante están en cien tiendas. Lo que no está en ninguna: la medida real que has tomado, el peso con embalaje, cuánto tarda en llegar a Canarias, qué devuelven los clientes y por qué. Es también lo que un asistente de compra lee para recomendar.
- Servicios locales. El precio orientativo de tu zona, el plazo real de una licencia en tu ayuntamiento, qué pide la normativa autonómica. El corpus para una búsqueda local suele ser tan pobre que dos párrafos con datos reales te ponen por delante.
- Cola larga. Para una keyword con veinte búsquedas al mes el corpus lo forman páginas genéricas que no responden a la pregunta exacta. Responderla con precisión es information gain casi gratis, y es donde vemos las citas en asistentes con menos esfuerzo.
Cómo medir el information gain de tu web (en cinco minutos)
Tienes tres caminos, de más rápido a más artesanal:
1. Con LLMFY. En el panel, la función Information Gain pide una URL y una keyword, extrae los competidores de la SERP, aplica el método frase a frase que has visto arriba y devuelve el score, la lista de frases duplicadas y compartidas, los huecos de contenido que cubren los competidores y no tú, y los datos numéricos que solo aportas tú. Si además quieres saber si cubres el tema tan bien como ellos, AIO Semántico compara tu página con hasta cinco competidores por intención, cobertura, similitud, actualidad y formato. Hay análisis gratuitos para probar las dos.
2. A mano, con embeddings. Si te manejas con Python: descarga el texto de los diez primeros resultados, trocea en frases, genera embeddings con cualquier modelo multilingüe, calcula la similitud coseno máxima de cada frase tuya contra el corpus y aplica los umbrales de 0,70 y 0,85. Son unas cuarenta líneas de código y tarda un par de minutos por URL.
3. La prueba de las tres pestañas. Sin herramientas: abre tus tres competidores principales, lee tu artículo sección a sección y, en cada una, pregúntate qué sabe el lector después de leerla que no sabía tras leer las otras tres. Si la respuesta es "nada", esa sección es compartida. Es menos preciso que el embedding, pero suficiente para detectar un artículo de score 20.
Sobre las herramientas SEO habituales, para que no las busques donde no está: Semrush y Ahrefs no miden information gain (miden volumen, dificultad y enlaces); Surfer, Clearscope y similares miden cobertura de términos, es decir, cuánto te pareces al corpus, que es justo lo contrario. A fecha de septiembre de 2026, ninguna de ellas documenta una comparación frase a frase contra la SERP; la hacen implementaciones propias como la de LLMFY o el método manual de arriba.
Ejemplo aplicado: este artículo
Para no predicar sin practicar, el día de la publicación pasé esta guía por la propia función Information Gain contra los diez primeros resultados de "information gain seo" en Google España, y por el Human-First Score de LLMFY, que mide si el texto suena a persona o a modelo.
- Information Gain: 93/100 en la primera versión, "altamente original". De 200 frases analizadas, 185 originales, 13 compartidas y 2 duplicadas, frente a un corpus de 8 competidores (Semrush, Search Engine Land, Cronuts Digital, Animalz, Backlinko y Studiohawk entre ellos). Las dos duplicadas eran, como avisaba más arriba, las dos definiciones: 88 % y 87 % de similitud con la de Cronuts Digital. Reescritas, el segundo análisis dio 95/100: 189 originales, 11 compartidas y 0 duplicadas. Los huecos que señaló (el uso del score en resultados secundarios, que cubre la propia patente) y las preguntas sin responder (autoridad temática, métricas de comportamiento, contenido transaccional, herramientas alternativas, caducidad de la ganancia, formatos no textuales y umbrales por nicho) son las secciones que has leído.
- Human-First Score: 72/100 en la primera versión, riesgo SEO bajo, 7 patrones en 4.401 palabras: seis palabras de vocabulario genérico ("aporta", "estima"), tres arranques que anunciaban lo que venía, dos afirmaciones de autoridad sin dato detrás, un paralelismo negativo, dos frases de relleno y una construcción rebuscada. Tras corregirlos y añadir mil palabras de secciones nuevas, el segundo análisis bajó a 67/100 (8 patrones en 5.431 palabras): las secciones nuevas traían sus propios arranques de calentamiento, tres atribuciones vagas ("la mayoría de artículos", "que sepamos") y tres frases de autoridad sin dato. Lección para quien amplíe un artículo: cada bloque nuevo hay que pasarlo por el mismo filtro que el original. Esta tercera versión, con esas instancias corregidas, volvió a 72/100 con 7 patrones en 5.575 palabras, e Information Gain se quedó en 94/100 sin frases duplicadas. Los detalles de cada pasada están en la sección de actualizaciones.
Si al leerlo encuentras una sección que repite lo que ya has visto en otro sitio, dímelo: es exactamente el tipo de frase que este método detecta.
Los errores que hunden el information gain
- Escribir a partir de las SERP. Si el proceso es "leo los diez primeros y redacto mi versión", el resultado es, por construcción, compartido. El proceso correcto empieza por lo que sabes o has medido y usa las SERP solo para comprobar qué falta.
- Generar el texto con IA sin datos propios. Un modelo de lenguaje produce, por diseño, la media de lo que ha leído: el corpus. El resultado suele puntuar entre 10 y 25. La IA sirve para estructurar, no para aportar.
- Añadir longitud en vez de información. Secciones de "historia de", "beneficios de" y "conclusión" añaden frases compartidas y bajan el score.
- Traducir una fuente en inglés y publicarla tal cual. Contra la SERP en español tiene algo de ganancia (el corpus español es más pobre), pero pierde toda la ventaja en cuanto otros traducen la misma fuente.
- Confundir original con raro. Frases originales que no responden a nada de lo que el usuario busca suben el score y bajan la utilidad. El objetivo es ganancia útil, no novedad por novedad.
Checklist antes de publicar
- Al menos un dato que solo tú puedas aportar, con su fecha y su método.
- Un caso, experimento o ejemplo con cifras reales, incluyendo lo que no funcionó.
- Una sección que discrepe o precise algo del consenso, con argumentos.
- Cifras concretas donde había adjetivos.
- Contexto local (precio, plazo, normativa) donde el corpus solo tiene contexto estadounidense.
- Una sección de límites: cuándo no aplica lo que cuentas.
- Ninguna sección cuyo único contenido sea una definición o una lista de beneficios genérica.
- Score de information gain medido antes de publicar y objetivo de mejora anotado para la siguiente revisión.
Preguntas frecuentes sobre el information gain
¿Es el information gain un factor de ranking confirmado por Google?
No. Existe una patente de Google (US 11.354.342 B2, concedida en 2022) que describe cómo calcular un score de information gain, y la documentación de contenido útil pide información y análisis originales, pero Google no ha confirmado que aplique ese score en el ranking. Lo que sí está confirmado es que los sistemas de IA con búsqueda deduplican pasajes antes de responder, y eso premia la información nueva de forma directa.
¿Cómo se mide el information gain de una página?
Comparando cada frase de la página con las frases de los resultados que ya rankean para la misma búsqueda, mediante embeddings y similitud coseno. Las frases con similitud máxima inferior a 0,70 se consideran originales; el score es el porcentaje de frases originales sobre el total. Herramientas como Information Gain de LLMFY automatizan el proceso.
¿Qué puntuación de information gain es buena?
A partir de 70 el contenido es muy original; entre 40 y 69, moderadamente original; por debajo de 40, mayoritariamente compartido. En los 25 análisis hechos con la herramienta entre junio y septiembre de 2026 la mediana fue 85, así que superar 70 es un objetivo realista para un contenido trabajado.
¿Un artículo más largo tiene más information gain?
No necesariamente. La longitud solo suma si las frases añadidas aportan información que el corpus no tiene. Añadir secciones de definiciones, beneficios o conclusiones genéricas aumenta la longitud y reduce el score, porque incrementa la proporción de frases compartidas.
¿Puedo conseguir information gain con contenido generado por IA?
Solo si la IA trabaja sobre datos que le das tú: resultados, cifras, casos, entrevistas. Un texto generado a partir de la propia formación del modelo reproduce la media de lo publicado y suele puntuar por debajo de 25. La IA es útil para estructurar y redactar; la información nueva tiene que salir de tu experiencia o de tus datos.
¿Qué relación hay entre information gain y E-E-A-T?
La experiencia (primera E de E-E-A-T) produce datos, errores y resultados que nadie más puede publicar: frases con similitud baja frente al corpus, es decir, information gain medible. Al auditar la misma URL con las dos herramientas, las páginas que suspenden en experiencia son las que describen un proceso sin haberlo hecho, y son también las que puntúan bajo en ganancia de información.
¿Cómo afecta el information gain a que ChatGPT o Perplexity citen mi página?
Los asistentes con búsqueda recuperan decenas de pasajes, descartan los redundantes y citan los que aportan algo distinto. Una página que repite el consenso no sobrevive a esa deduplicación aunque rankee primera en Google; una que aporta un dato, un ejemplo con cifras o una excepción tiene muchas más probabilidades de ser citada.
¿Con qué frecuencia hay que revisar el information gain de un contenido?
Al menos una vez al año en los contenidos que importan, y siempre que aparezcan nuevos competidores en la SERP. La ganancia caduca: cuando un competidor publica tu dato, la similitud de esa frase con el corpus supera 0,70 y deja de contar como original. Medir el score antes y después de cada revisión permite comprobar que la actualización ha aportado y no solo cambiado la fecha.
Conclusiones
- El information gain mide cuánto aporta tu página frente a lo que ya existe; es semántico, relativo al corpus y no depende de la longitud.
- La patente de Google (2022, renovada hasta 2025) describe el mecanismo, pero no confirma su uso en el ranking. La búsqueda con IA, en cambio, lo aplica de forma visible al deduplicar pasajes.
- Se puede medir frase a frase con embeddings: por debajo de 0,70 de similitud con el corpus, la frase es original; el score es el porcentaje de frases originales.
- Lo que más lo sube son los datos propios, los experimentos y los casos con cifras; lo que más lo baja es escribir a partir de las SERP o generar texto con IA sin datos.
- Mide antes y después de cada revisión. Sin número, la "originalidad" es una opinión.
Si quieres saber el score de una página tuya, puedes analizarla gratis con Information Gain y comprobar su cobertura frente a la competencia con AIO Semántico: en unos minutos tienes el porcentaje de frases originales, las duplicadas y los huecos que cubren tus competidores y tú no.
Fuentes y referencias
- Google Patents. US 11.354.342 B2, Contextual estimation of link information gain. Carbune y Gonnet, solicitud del 18 de octubre de 2018, concesión del 7 de junio de 2022. Continuaciones US 11.720.613, US 12.013.887 y US 12.326.889.
- Google Search Central. Cómo crear contenido útil, fiable y centrado en las personas. Preguntas sobre información, investigación y análisis originales.
- Aggarwal y otros (Princeton, Georgia Tech, IIT Delhi). GEO: Generative Engine Optimization. KDD 2024. Efecto de citas, estadísticas y citas textuales en la visibilidad generativa.
- Joren y otros (Google Research). Sufficient Context: A New Lens on Retrieval Augmented Generation Systems. ICLR 2025.
- BrightEdge. Seguimiento de AI Overviews durante 16 meses: solo el 17 % de las citas proceden del top 10 orgánico.
- Search Engine Land. Information gain in SEO: What it is and why it matters. Primer análisis divulgativo de la patente.
- LLMFY. Método frase a frase, umbrales de 0,70 y 0,85 y grados del score, tal como se implementan en la función Information Gain del panel.
Actualizaciones
- 8 de septiembre de 2026, publicación. Primer análisis de la propia guía: Information Gain 93/100 (185 de 200 frases originales, 2 duplicadas) y Human-First Score 72/100 (7 patrones, 4.401 palabras). Reescritas las dos definiciones duplicadas y las frases marcadas; añadidas las secciones sobre autoridad temática, métricas de comportamiento, contenido transaccional y local, herramientas alternativas y caducidad de la ganancia.
- 8 de septiembre de 2026, segunda revisión. Segundo análisis: Information Gain 95/100 (189 originales, 0 duplicadas); Human-First Score 67/100 (8 patrones, 5.431 palabras) porque las secciones nuevas traían arranques de calentamiento, atribuciones vagas y frases de autoridad sin dato. Corregidas, más los límites del método (formatos no textuales, umbrales por nicho, competidores con texto de IA). Tercer análisis: Information Gain 94/100 (187 originales, 13 compartidas, 0 duplicadas) y Human-First Score 72/100 (7 patrones, 5.575 palabras, riesgo bajo). Entre 67 y 72 con el mismo texto de base hay ruido del modelo; la mejora real está en que ya no queda ninguna frase duplicada y en que las atribuciones vagas se han sustituido por datos del propio análisis.
Jesus LopezSEO
Experto en LLMO y Fundador de LLMFY
SEO expert with over 18 years of experience. Pioneer in LLMO (Large Language Model Optimization) and founder of Posicionamiento Web Systems. Helping companies optimize their presence in traditional search engines and AI search engines.