HTML Semántico: Qué Es, Etiquetas y Cómo Lo Lee la IA (2026)
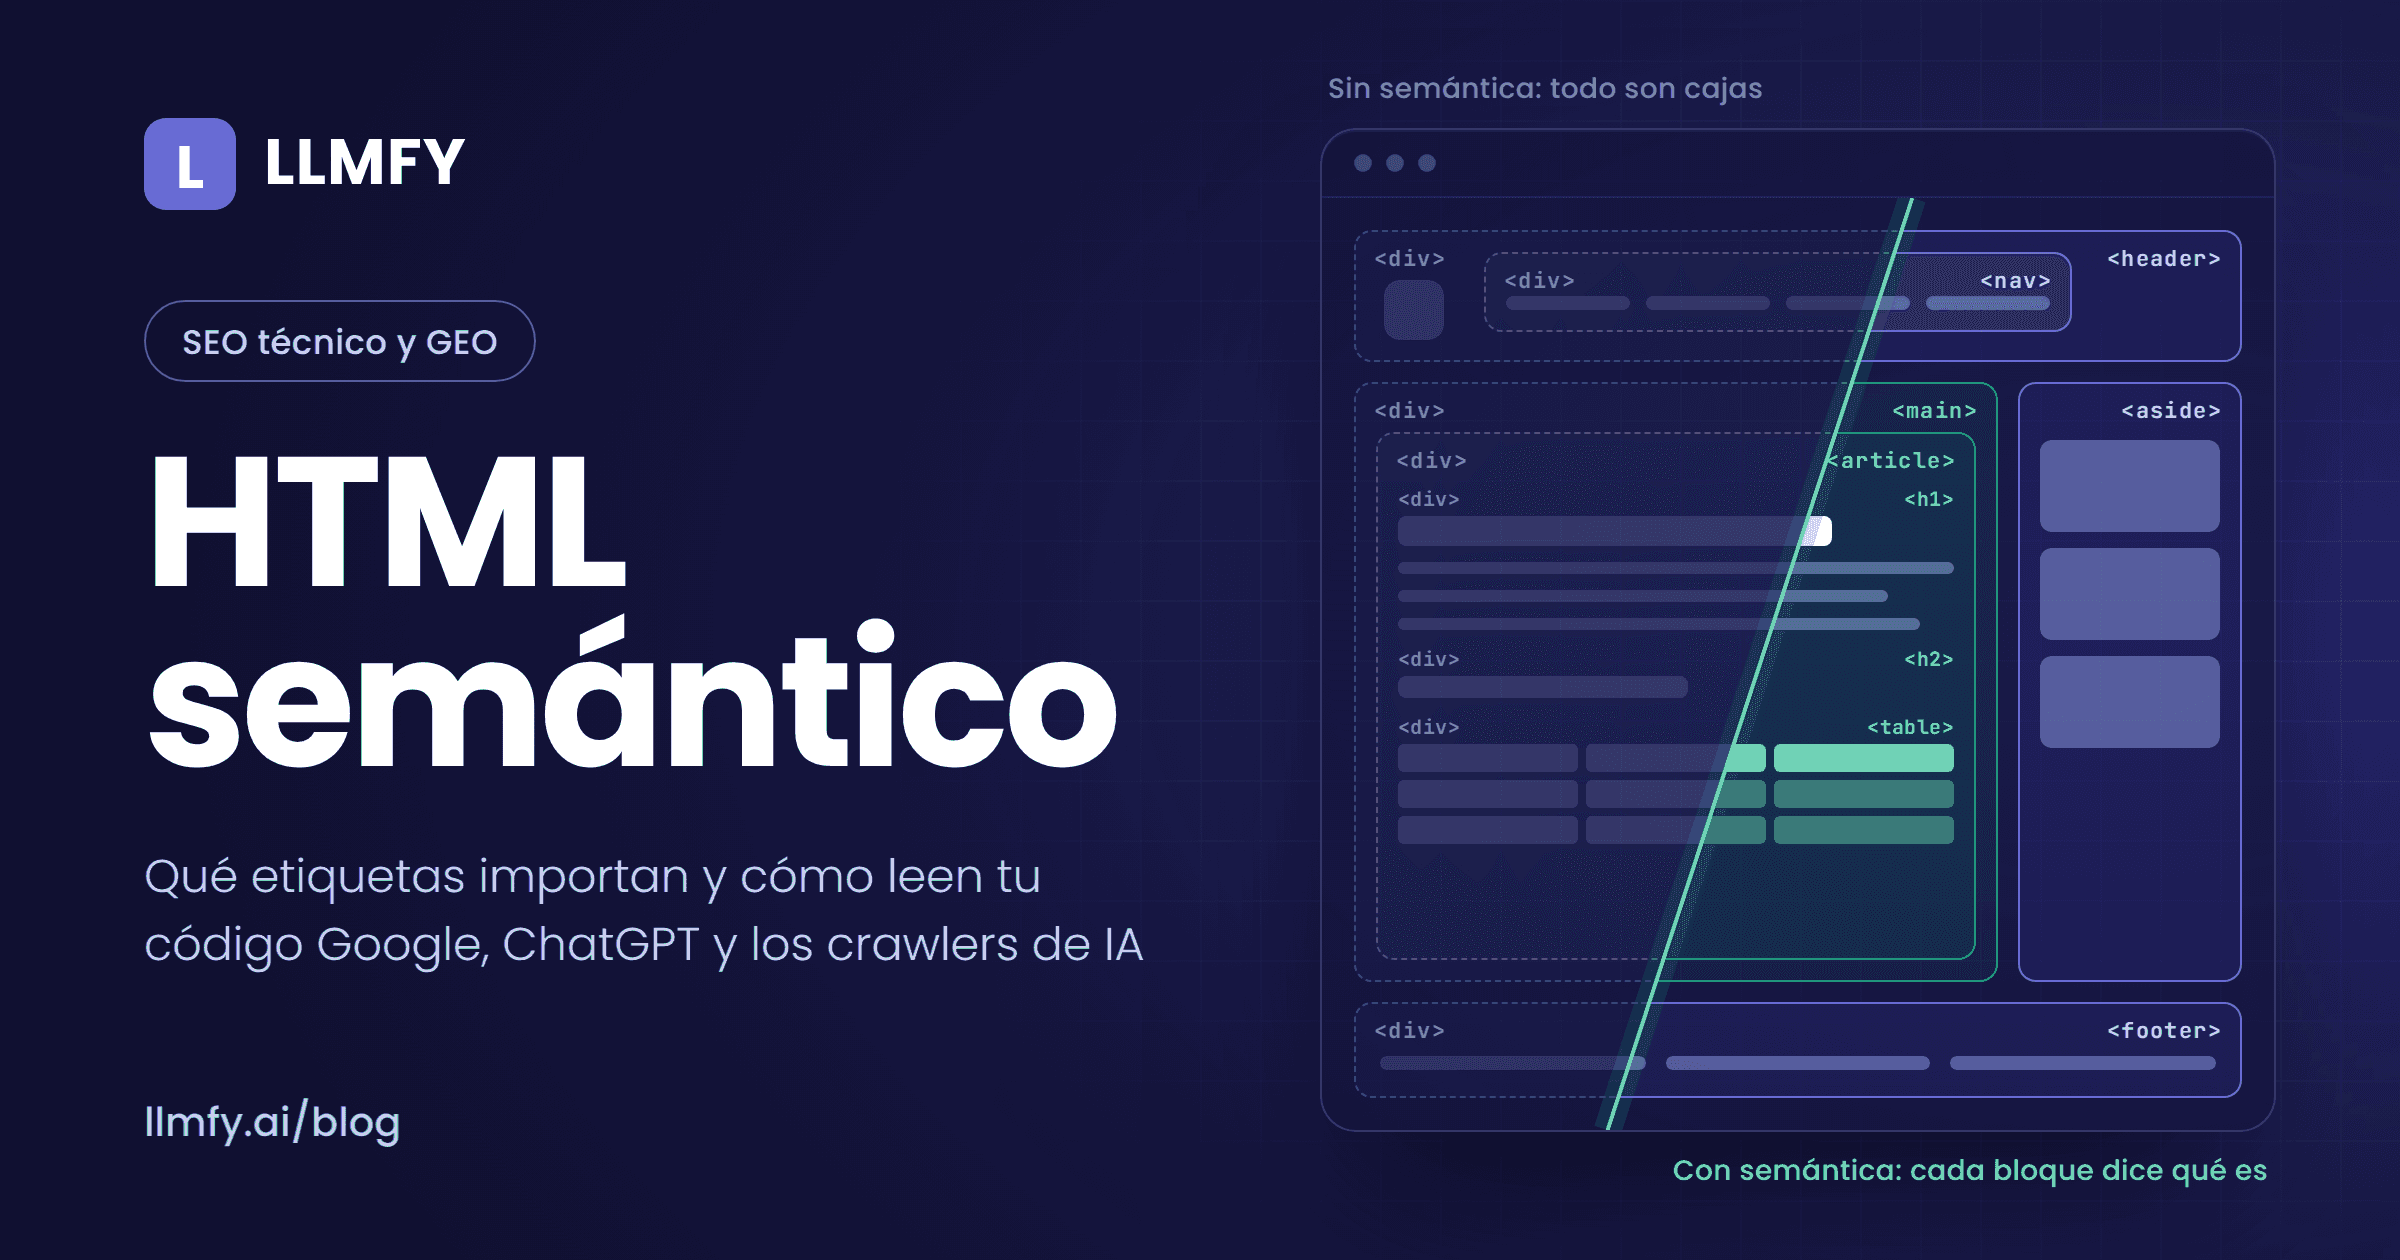
El HTML semántico es la forma de escribir una página usando cada etiqueta por lo que significa y no por cómo se ve: <nav> para la navegación, <h2> para un apartado, <button> para un botón y <table> para datos en filas y columnas. Al navegador le da igual. A Google, a los lectores de pantalla y a los sistemas de IA que leen tu web, no.
Llevo más de 18 años en SEO y durante casi todos ellos el HTML semántico ha sido "buena práctica": algo que el equipo de desarrollo hacía si sobraba tiempo. Eso ha cambiado. Los crawlers de ChatGPT, Claude o Perplexity no ejecutan JavaScript. Las librerías que convierten tu página en texto para entrenar modelos o para citarte deciden qué es contenido y qué es menú mirando tus etiquetas. Y los navegadores con agente, como ChatGPT Atlas, recorren tu web a través del árbol de accesibilidad, que se construye con el HTML.
Para este artículo he hecho dos cosas que no vas a encontrar en las guías que posicionan hoy. Primero, un experimento: la misma página maquetada de tres formas y pasada por los extractores de texto que usan los datasets de IA. Segundo, una auditoría del HTML de las 15 páginas que posicionan para esta keyword en Google España y Google Estados Unidos. Adelanto un dato: el tutorial más conocido del mundo sobre elementos semánticos sirve seis H1.
¿Qué es el HTML semántico? Definición y ejemplo
Una etiqueta es semántica cuando su nombre describe su función. <div> y <span> no dicen nada, son cajas. <article>, <nav> o <time> sí dicen algo, y cualquier programa que lea tu código puede actuar en consecuencia sin tener que adivinar.
Mira estas dos versiones del mismo bloque:
<!-- Sin semántica: todo son cajas -->
<div class="header">
  <div class="menu">
    <div onclick="location.href='/blog'">Blog</div>
  </div>
</div>
<div class="content">
  <div class="title">Guía de suelos para garaje</div>
  <div class="subtitle">Precios por metro cuadrado</div>
</div>

<!-- Con semántica: cada etiqueta dice qué es -->
<header>
  <nav aria-label="Principal">
    <a href="/blog">Blog</a>
  </nav>
</header>
<main>
  <article>
    <h1>Guía de suelos para garaje</h1>
    <h2>Precios por metro cuadrado</h2>
  </article>
</main>
En pantalla pueden ser idénticas. Con CSS puedes hacer que un <div> parezca un titular y que un <h2> parezca texto normal. La diferencia está en lo que percibe quien no mira la pantalla: en la primera versión, un crawler no encuentra ningún enlace, un lector de pantalla no encuentra ningún encabezado y un agente de IA no sabe qué es el menú.
Un matiz que casi ninguna guía explica: semántico no significa "HTML5". <p>, <ul>, <table>, <a> o <h1> existen desde los noventa y son tan semánticas como <article>. HTML5 añadió las etiquetas de estructura (<header>, <nav>, <main>, <article>, <section>, <aside>, <footer>) y el estándar sigue vivo: <search> entró en la especificación en 2023.
HTML semántico, Schema, SEO semántico y web semántica no son lo mismo
La palabra "semántico" aparece en cuatro conceptos distintos y se mezclan constantemente:
| Concepto | Qué describe | Dónde vive |
|---|---|---|
| HTML semántico | La función de cada bloque de la página: esto es un menú, esto un artículo, esto una tabla | Las etiquetas HTML |
| Datos estructurados (Schema) | Entidades y sus propiedades: este artículo lo escribió esta persona en esta fecha | JSON-LD, normalmente |
| SEO semántico | El significado y la cobertura del tema en el texto | El contenido |
| Web semántica | Datos enlazados entre sitios (RDF, OWL), un proyecto del W3C de los 2000 | Formatos de datos |
Si te interesa la segunda fila, la tienes en nuestra guía de Schema para LLMs. La tercera, en la de SEO semántico. Este artículo va de la primera.
Quién lee tu HTML en 2026 (y ninguno lo lee como tú)
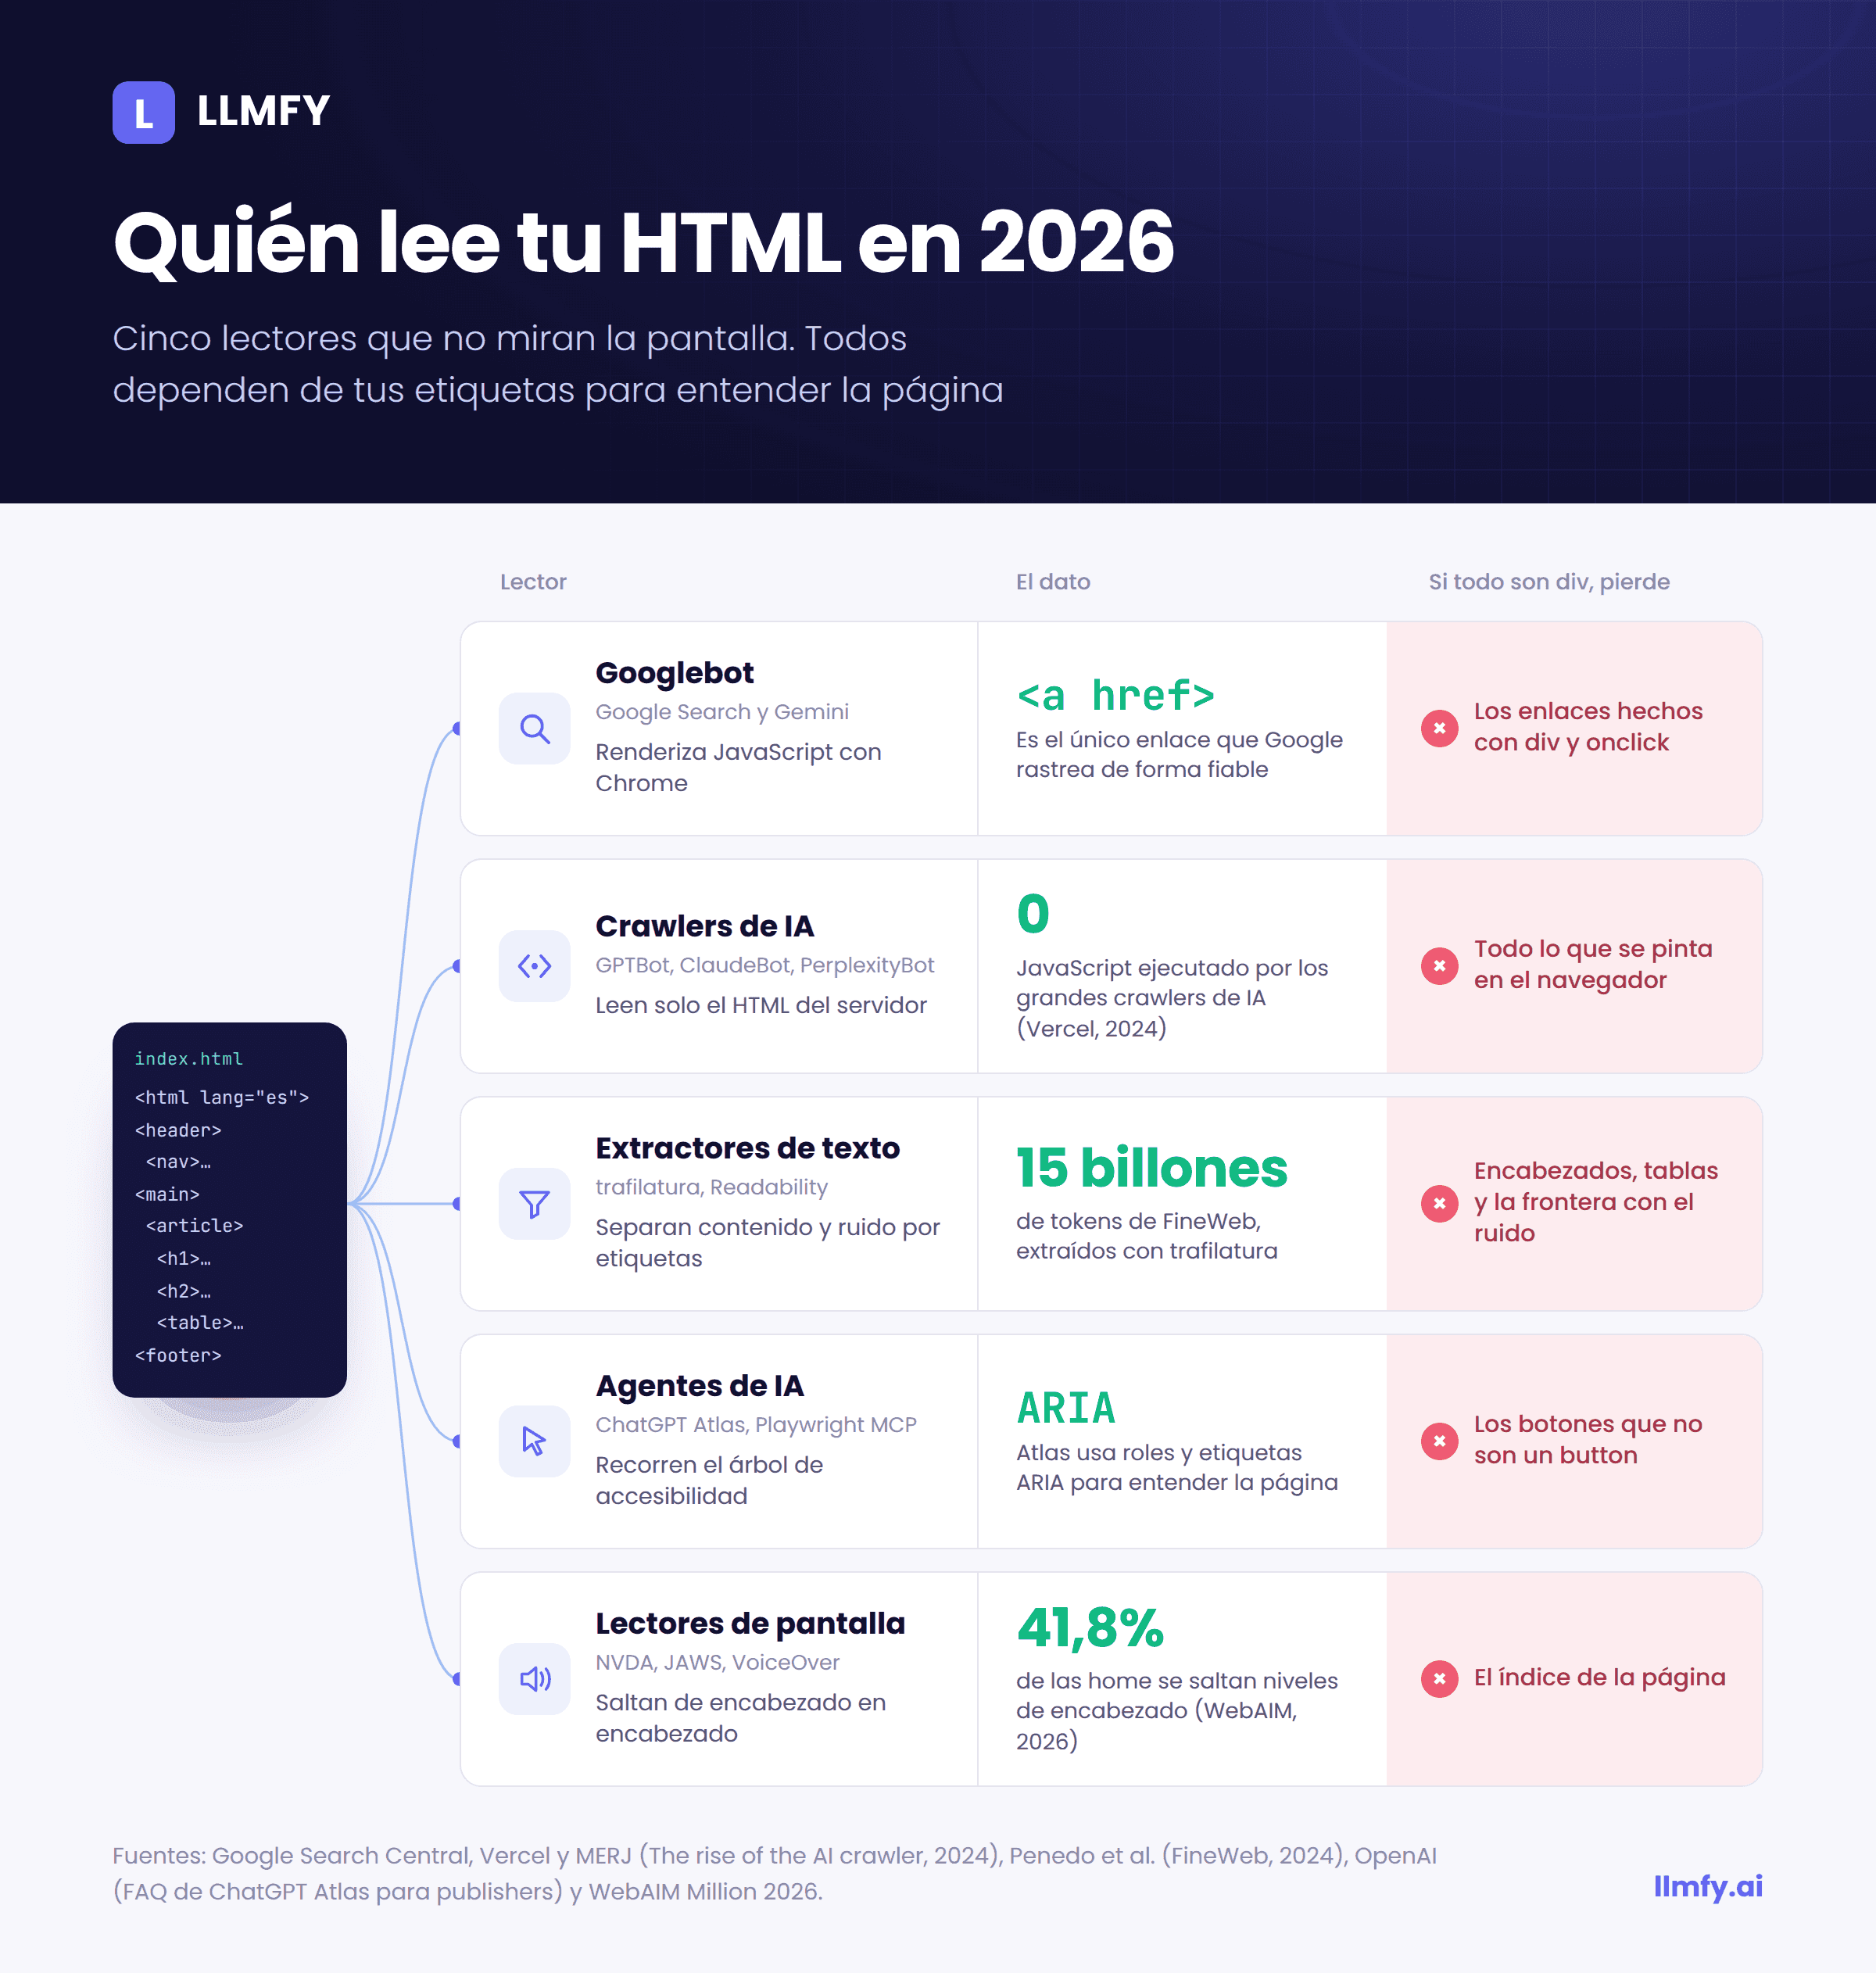
Cuando piensas en tu página, piensas en lo que se ve. Pero la mayoría de sus lectores no ven nada: leen código. Estos son los cinco que más importan hoy:
| Lector | Cómo lee tu página | Qué pierde si todo son divs |
|---|---|---|
| Googlebot | Renderiza JavaScript con Chrome, pero solo sigue enlaces a con href | Enlaces que no descubre y peor delimitación del contenido principal |
| Crawlers de IA (GPTBot, ClaudeBot, PerplexityBot) | Leen el HTML que devuelve el servidor, sin ejecutar JavaScript | Todo lo que se pinta en el navegador |
| Extractores de texto (trafilatura, Readability) | Separan contenido de menús usando etiquetas y nombres de clase | Encabezados, tablas y la frontera entre contenido y ruido |
| Agentes de navegador (ChatGPT Atlas, Playwright MCP) | Árbol de accesibilidad: roles y nombres accesibles | Botones, enlaces y campos que no sabe identificar |
| Lectores de pantalla | Árbol de accesibilidad | La navegación por encabezados y regiones |
Googlebot renderiza, pero no hace clic
La documentación de Google es explícita: en general solo puede rastrear un enlace si es un elemento <a> con atributo href. Un <div onclick> o un <a> sin href que navega por JavaScript no se extrae de forma fiable. Da igual lo bien que renderice Google: renderizar no es pulsar.
Sobre el resto de etiquetas, John Mueller lo dejó claro en un vídeo de Search Central de 2023: el HTML semántico no es un factor de ranking, pero ayuda a los sistemas de Google a entender mejor el contenido. En otra ocasión, preguntado por <article>, respondió que esa etiqueta no tiene ningún efecto particular en la búsqueda y que hay razones de accesibilidad y de semántica para usarla más allá del SEO.
Los crawlers de IA no ejecutan JavaScript
Vercel y MERJ analizaron el tráfico de crawlers en la red de Vercel y publicaron los resultados en diciembre de 2024. En un mes, GPTBot hizo 569 millones de peticiones y el crawler de Anthropic, 370 millones. Ninguno de los grandes crawlers de IA ejecutaba JavaScript: descargan a veces los ficheros .js, pero no los ejecutan. Solo Googlebot (que también alimenta a Gemini) y AppleBot renderizaban la página.
Traducido: si tu contenido, tus enlaces o tus encabezados aparecen solo después de que se ejecute JavaScript, para ChatGPT o Claude no existen. El HTML que devuelve tu servidor es tu única oportunidad, y cuanto más claro sea, mejor.
Los datasets y los sistemas de respuesta trabajan con texto extraído
Ningún modelo lee tu HTML tal cual. Antes pasa por un extractor que decide qué es contenido y qué es menú, cookies o pie de página. El caso mejor documentado es FineWeb, el dataset abierto de 15 billones de tokens de Hugging Face: sus autores descartaron el texto que ofrece Common Crawl por defecto porque arrastraba demasiado menú y boilerplate, y extrajeron el texto del HTML original con la librería trafilatura. Los modelos entrenados con ese texto limpio rindieron mejor.
Ese paso intermedio es donde tu marcado se convierte en ventaja o en problema. Por eso monté el experimento que verás más abajo.
Los agentes navegan por el árbol de accesibilidad
El árbol de accesibilidad es la versión de tu página que el navegador construye para las tecnologías de asistencia: una lista de roles (botón, enlace, encabezado, región) con sus nombres. OpenAI indica en sus FAQ para publishers que ChatGPT Atlas usa las etiquetas ARIA, las mismas que usan los lectores de pantalla, para interpretar la estructura de la página y sus elementos interactivos. El servidor MCP oficial de Microsoft para Playwright entrega a los modelos instantáneas del árbol de accesibilidad en lugar de capturas de pantalla.
Si tu botón de "Añadir al carrito" es un <div> con un evento de clic, un agente que compra por el usuario no tiene forma limpia de saber que eso es un botón.
El experimento: la misma página, tres maquetaciones
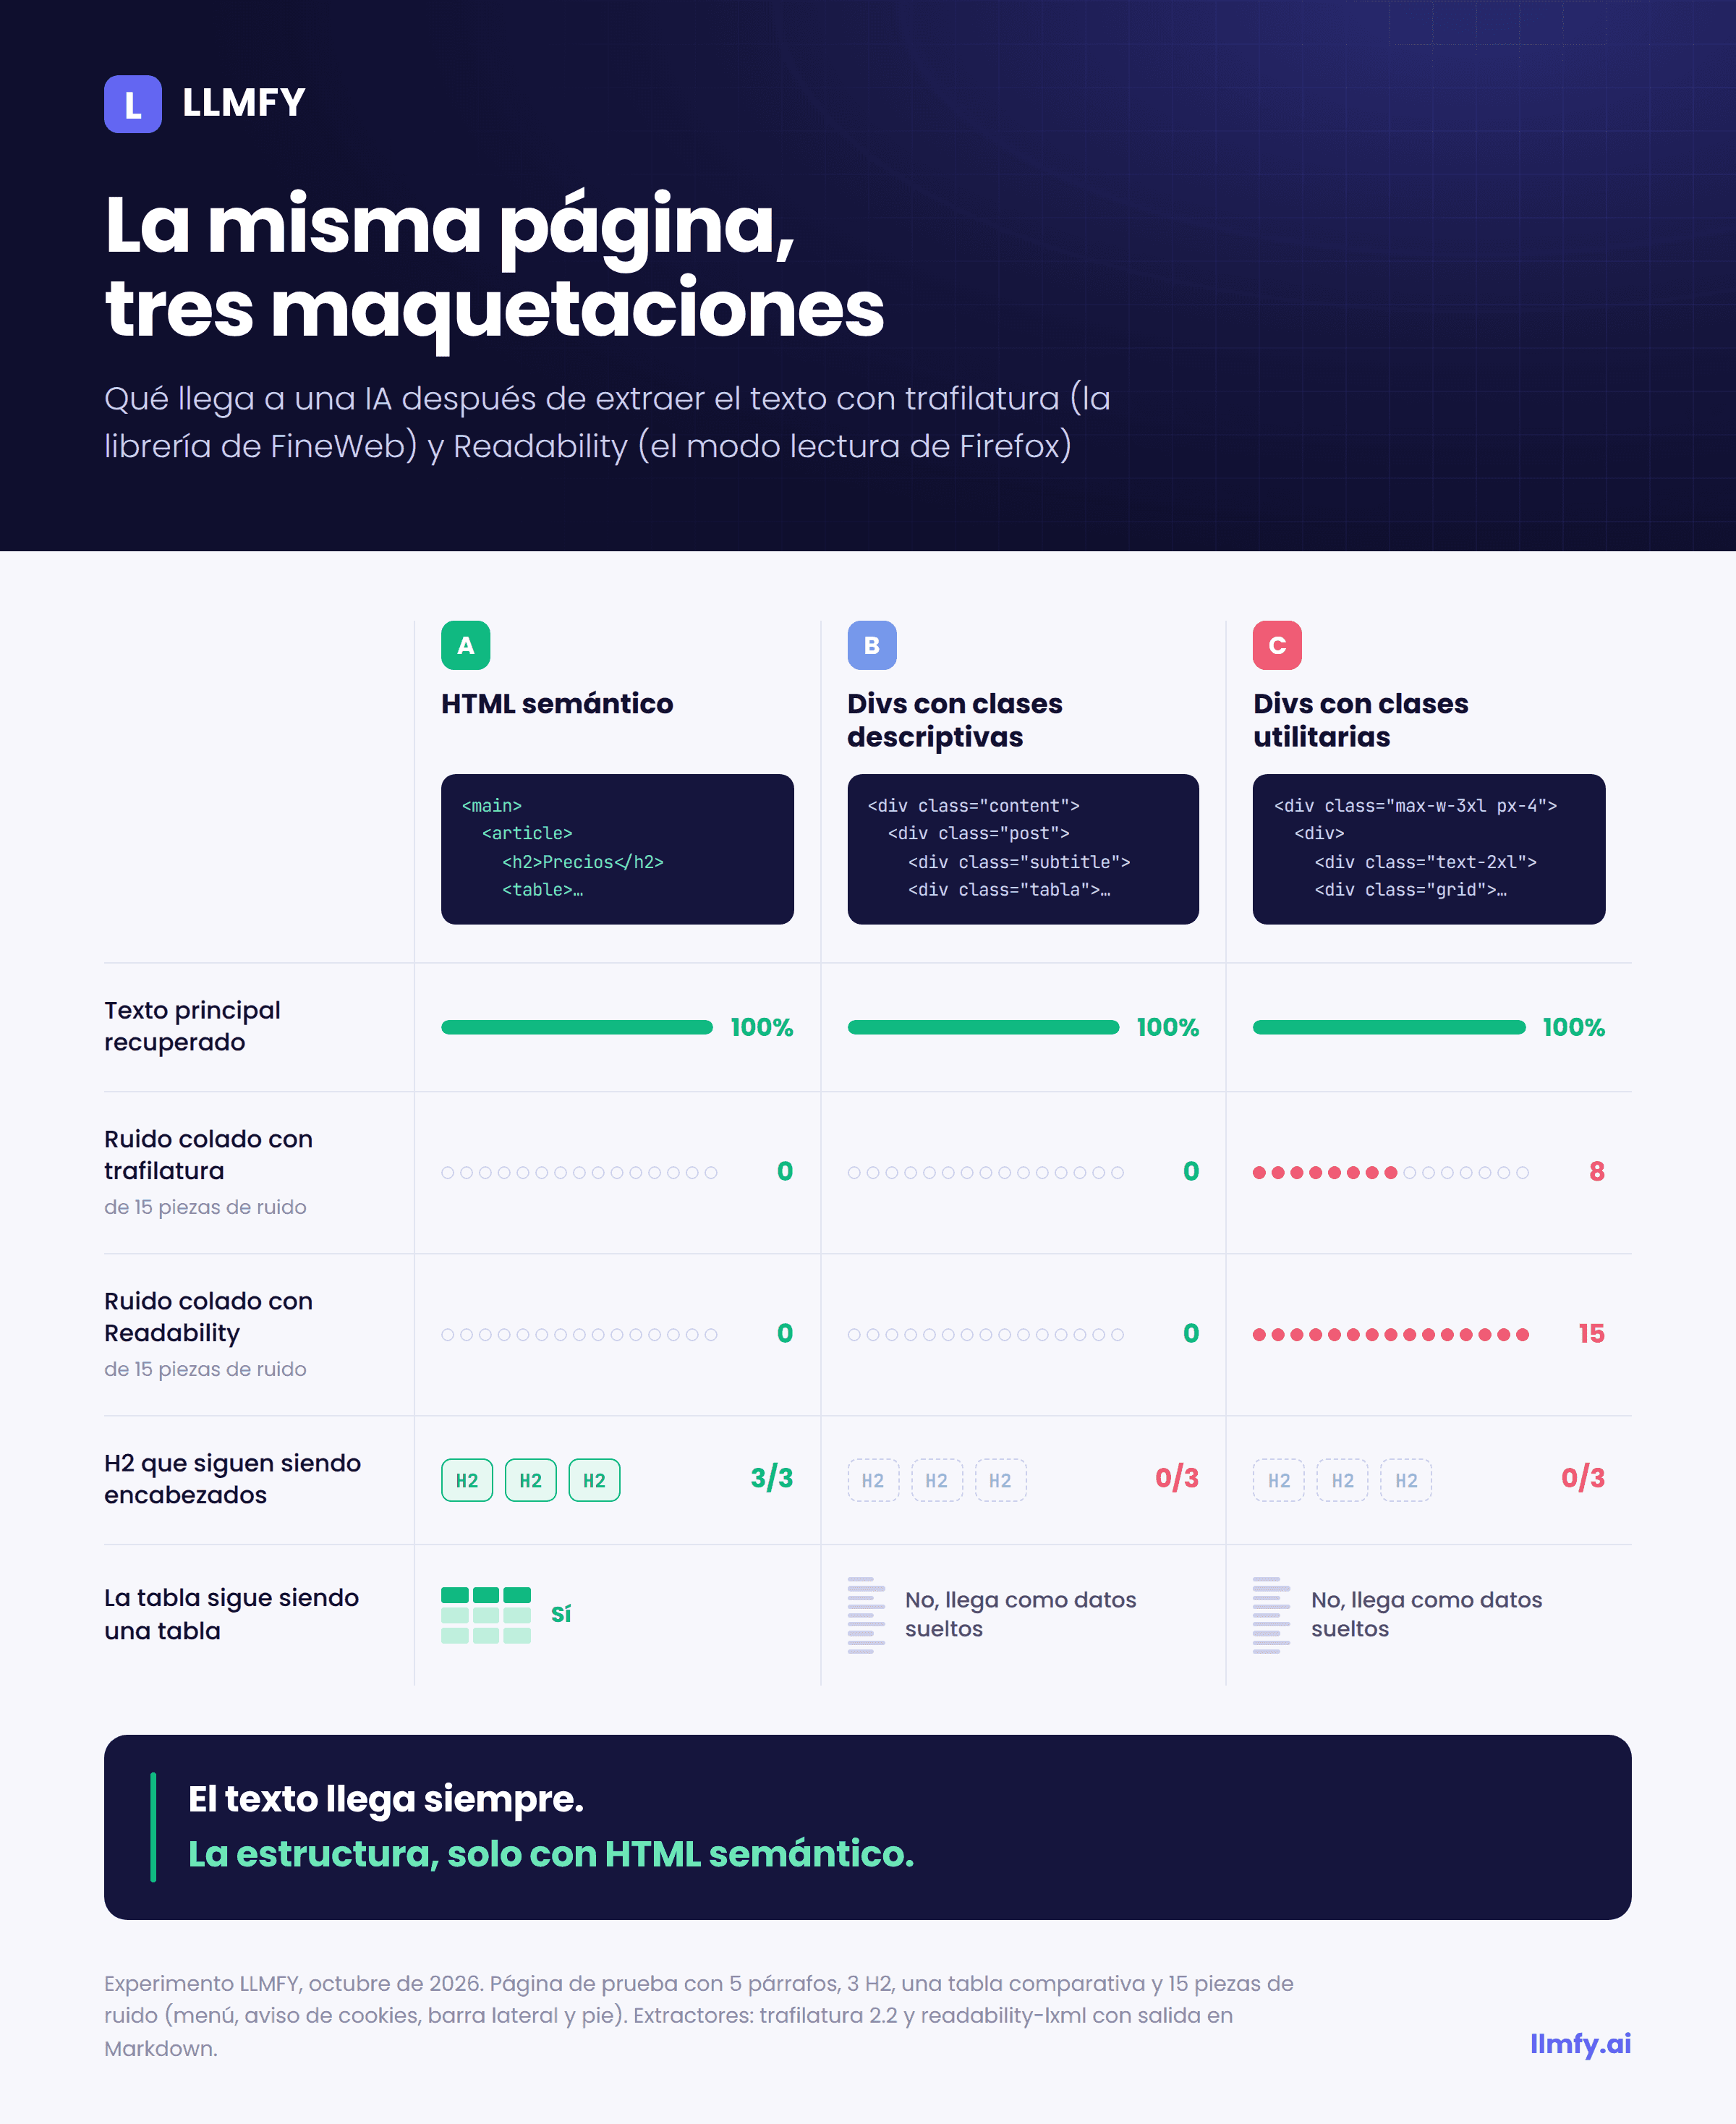
Quería comprobar algo concreto: si el marcado cambia lo que llega a una IA después de la extracción. Así que construí una página de ejemplo (una guía corta de suelos para garaje) con cinco párrafos, tres H2 y una tabla comparativa de tres materiales. Alrededor puse 15 piezas de ruido típico: un menú de seis enlaces, un aviso de cookies, una barra lateral con artículos relacionados y newsletter, y un pie con textos legales.
La maqueté de tres formas, visualmente equivalentes:
- A. Semántica:
<header>,<nav>,<main>,<article>,<h1>/<h2>,<table>con<th>,<aside>y<footer>. - B. Divs con clases descriptivas: todo son
<div>, pero con clases comoheader,menu,sidebarofooter. - C. Divs con clases utilitarias: todo son
<div>con clases estilo Tailwind (flex,px-6,text-2xl…), algo muy habitual en webs hechas con frameworks modernos.
Pasé las tres versiones por dos extractores: trafilatura 2.2 (la librería de FineWeb) con salida en Markdown, y readability-lxml (el port en Python del algoritmo del modo lectura de Firefox) convertido a Markdown con html2text. Resultados:
| Versión | Extractor | Texto principal recuperado | Piezas de ruido coladas (de 15) | H2 conservados como encabezado | Tabla conservada como tabla |
|---|---|---|---|---|---|
| A. Semántica | trafilatura | 100% | 0 | 3 de 3 | Sí |
| A. Semántica | Readability | 100% | 0 | 3 de 3 | Sí |
| B. Divs descriptivos | trafilatura | 100% | 0 | 0 de 3 | No |
| B. Divs descriptivos | Readability | 100% | 0 | 0 de 3 | No |
| C. Divs utilitarios | trafilatura | 100% | 8 | 0 de 3 | No |
| C. Divs utilitarios | Readability | 100% | 15 | 0 de 3 | No |
Tres lecturas:
1. El texto llega siempre; la forma, no. Ningún extractor perdió un solo párrafo. La diferencia está en con qué llega acompañado y con qué estructura. Solo la versión semántica conservó los tres H2 como encabezados. En B y C, "Comparativa de precios por metro cuadrado" llegó como una línea más de texto, indistinguible de un párrafo corto.
2. La tabla se desmonta. En la versión semántica la tabla salió como tabla Markdown. En B y C se convirtió en una columna de datos sueltos:
Material
Precio/m²
Vida útil
Resina epoxi
35–60 €
10–15 años
Microcemento
45–80 €
8–12 años
Un modelo puede intentar reconstruir la relación entre material y precio, pero ya no está escrita. Frente a eso, la versión semántica entregó esto:
| Material | Precio/m² | Vida útil |
|---|---|---|
| Resina epoxi | 35–60 € | 10–15 años |
| Microcemento | 45–80 € | 8–12 años |
3. Con clases utilitarias, el ruido se cuela. Los extractores usan nombres de clase como pista: por eso la versión B, con sidebar y footer, salió limpia. Cuando las clases no dicen nada (versión C), trafilatura coló 8 de las 15 piezas de ruido (los artículos relacionados, la newsletter y los textos legales) y Readability las coló todas. Es decir, sin etiquetas semánticas dependes de que tu desarrollador haya bautizado bien sus clases.
Límites honestos del experimento: es una página sintética y corta, probada con dos extractores de código abierto. OpenAI, Google y Anthropic no publican sus pipelines internos, así que esto no reproduce lo que hace cada uno. Es un resultado direccional, y va en la misma dirección que todo lo anterior.
Auditoría: el HTML de las páginas que posicionan para "HTML semántico"
El 1 de octubre de 2026 descargué el HTML de las páginas del top 10 para "html semántico" en Google España y para "semantic html" en Google Estados Unidos, según Semrush. Lo hice sin ejecutar JavaScript, que es como las ve un crawler de IA. Me quedaron 15 URLs válidas (dos bloquearon la descarga). Lo que encontré:
- 4 de 15 no tienen
<main>, así que no declaran cuál es el contenido principal. - 4 de 15 se saltan niveles de encabezado (de H2 a H4, por ejemplo).
- 7 de 15 no tienen datos estructurados en JSON-LD (entre ellas MDN y web.dev, que son documentación técnica y quizá no lo necesiten).
- El tutorial de W3Schools sobre elementos semánticos sirve seis H1. Son los títulos de su menú ("Tutorials", "References"…). Además tiene cuatro saltos de nivel y unos 50
<div>por cada etiqueta semántica. - Una página de agencia sobre "HTML semántico y SEO" tiene tres H2 antes de su H1: los encabezados de los desplegables del menú.
- Una de las páginas tiene 42 de sus 185 imágenes sin atributo
alt****.
No lo cuento para señalar a nadie. Fíjate en el patrón: casi todos los fallos están en la plantilla (menús, barras laterales, pies), no en el artículo. Quien escribe el contenido suele hacerlo bien. El tema de WordPress, el constructor visual o el componente de menú lo estropean después.
Los datos del WebAIM Million 2026, que analiza cada año las páginas de inicio de un millón de webs, dicen lo mismo a gran escala: solo el 46,1% de las home tiene un <main>, el 18,1% tiene más de un H1 y el 41,8% se salta niveles de encabezado.
Las etiquetas semánticas que importan, por familias
Estructura de la página
| Etiqueta | Para qué sirve | Error típico |
|---|---|---|
header | Cabecera de la página o de un bloque (un artículo también puede tener la suya) | Usarla para cualquier franja visual de arriba |
nav | Bloques de navegación importantes: menú principal, migas de pan, índice | Envolver cada lista de enlaces del pie en un nav |
main | El contenido principal. Uno visible por página | No tenerlo, o tener dos |
article | Pieza autocontenida que tiene sentido sola: un post, una ficha, un comentario | Envolver la página entera, menú incluido |
section | Apartado temático, con su propio encabezado | Usarla como un div con otro nombre |
aside | Contenido relacionado pero prescindible: barra lateral, nota al margen | Meter ahí contenido principal |
footer | Pie de la página o de un bloque: autoría, legales, enlaces secundarios | Meter en él el formulario de contacto principal |
search | La zona de búsqueda del sitio (añadida en 2023) | Seguir usando un div con role="search" |
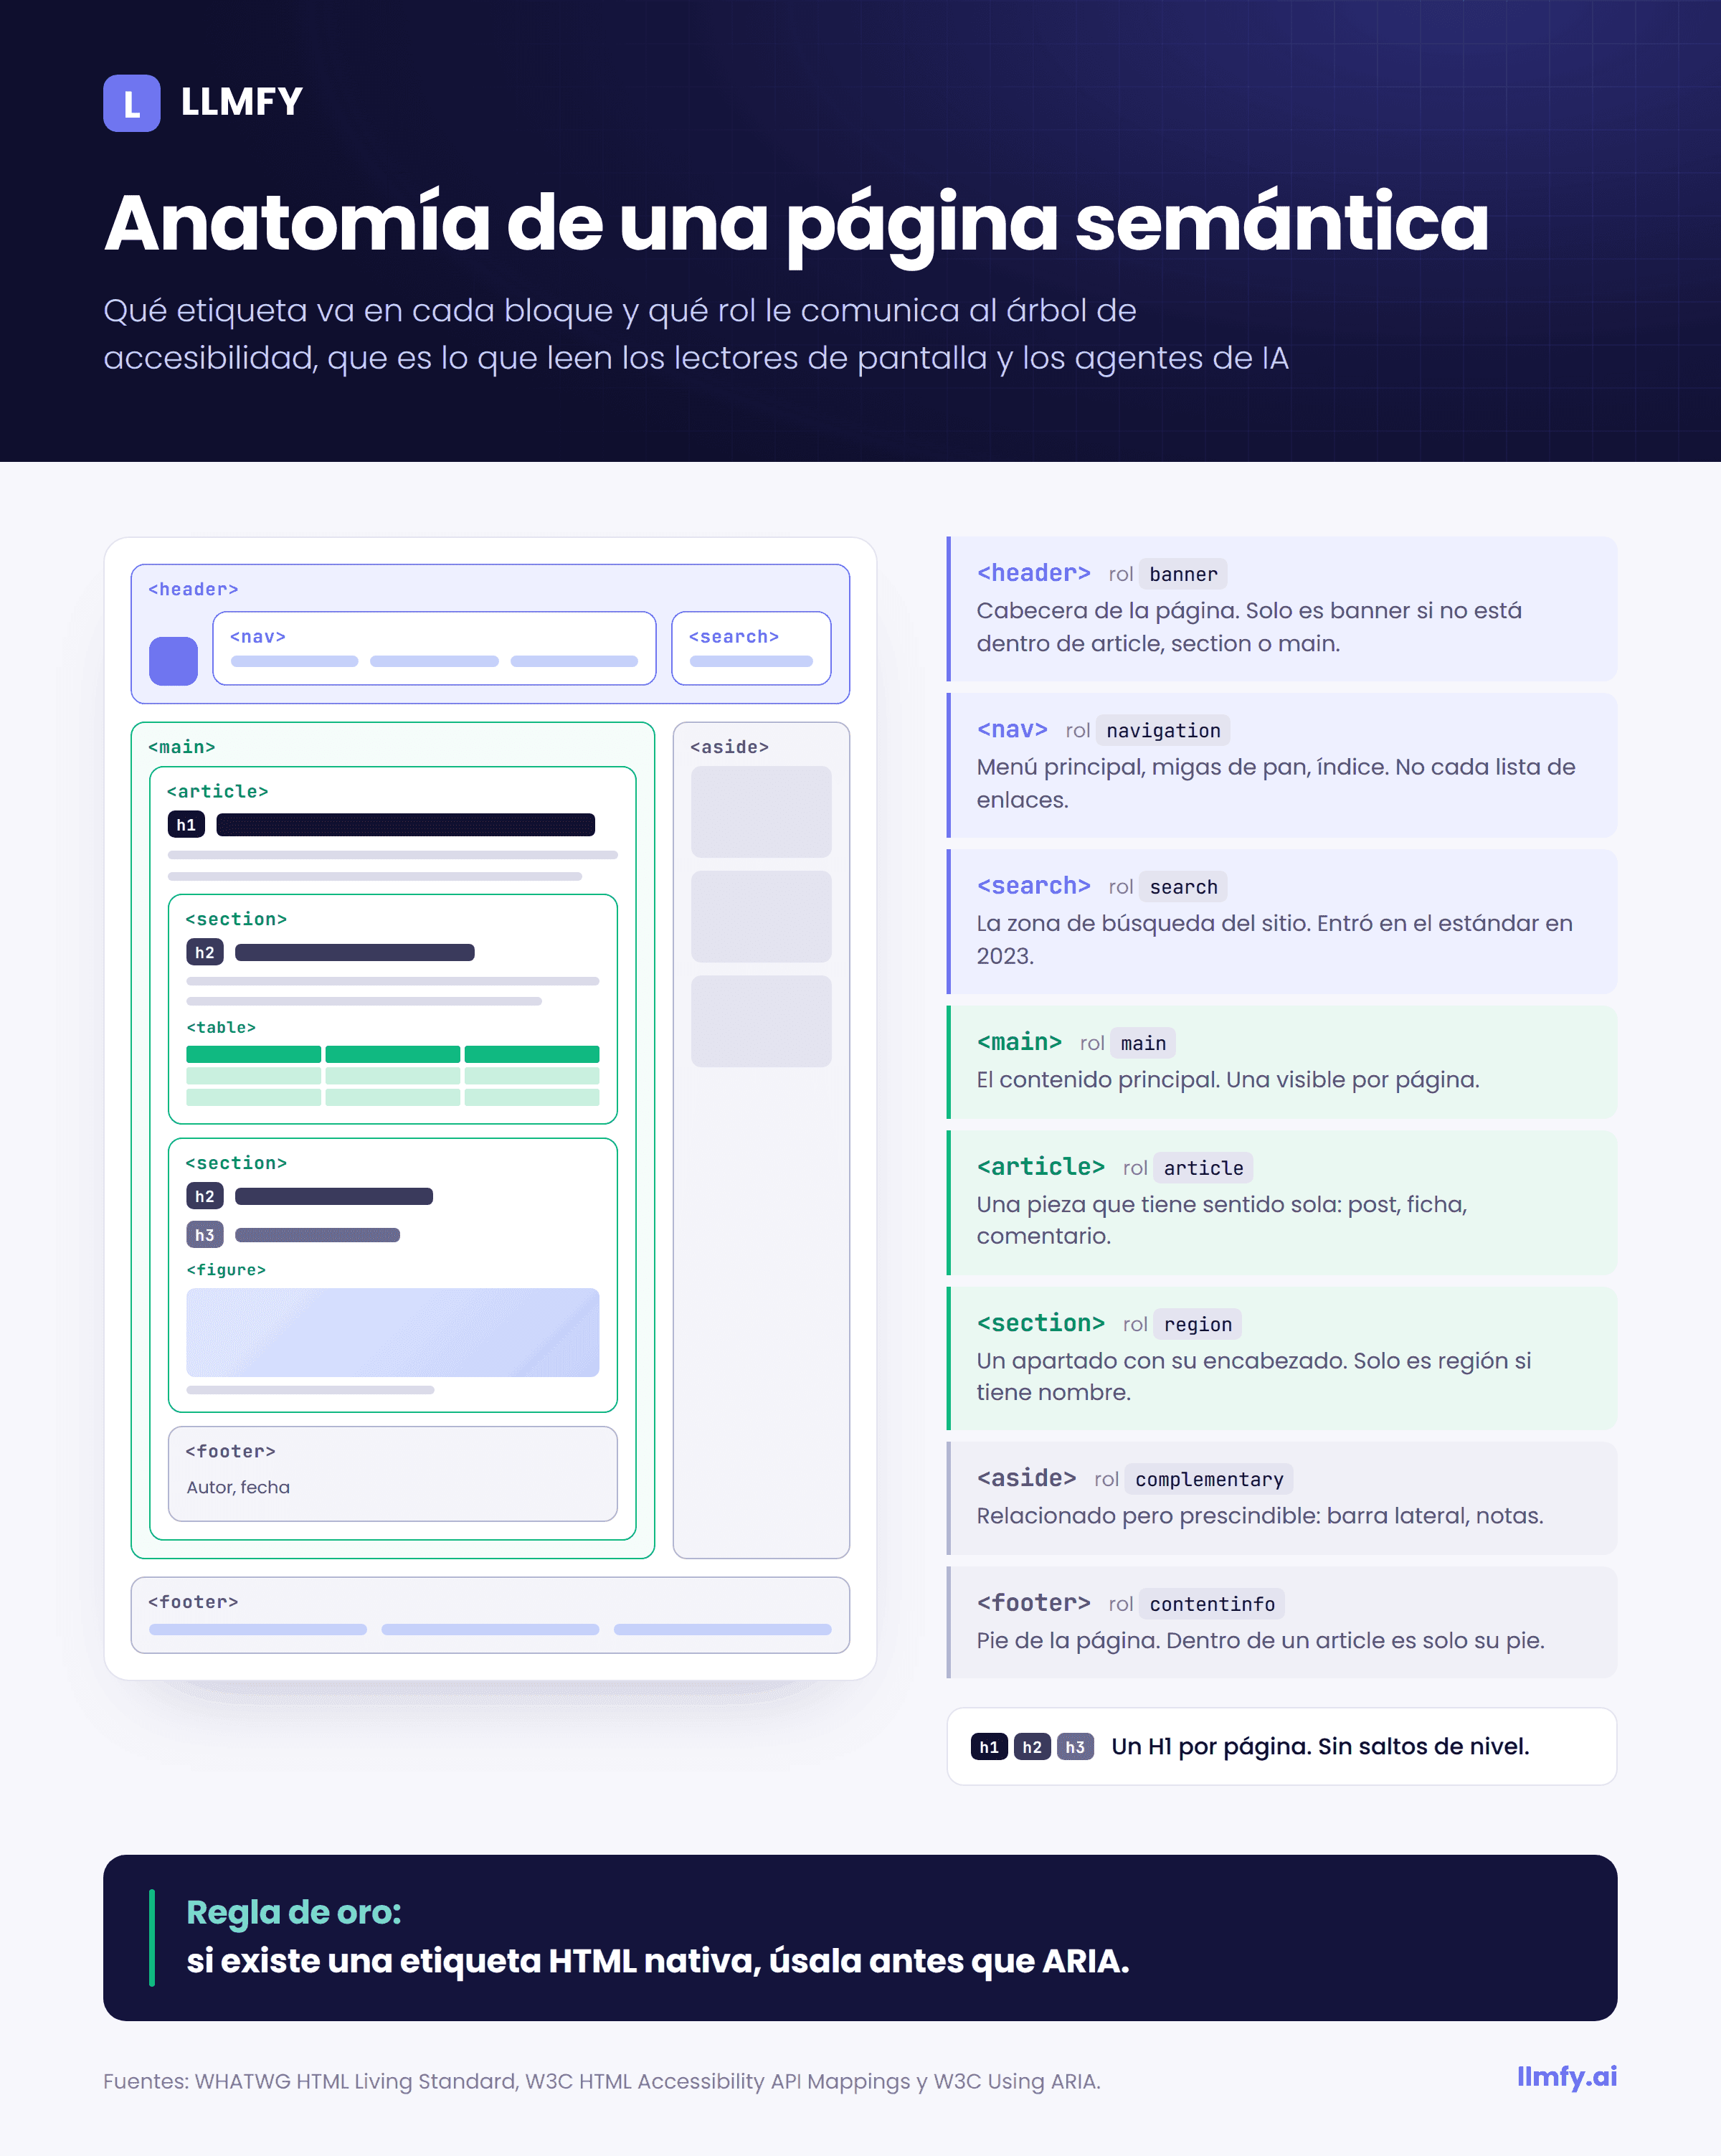
Dos detalles que marcan la diferencia en el árbol de accesibilidad: <header> y <footer> solo cuentan como cabecera y pie de la página cuando no están dentro de un <article>, <section> o <main>. Y un <section> solo se expone como región si tiene nombre, normalmente con aria-labelledby apuntando a su encabezado.
Esta es la estructura que uso como base para un post de blog:
<body>
  <header>
    <a href="/">Marca</a>
    <nav aria-label="Principal">…</nav>
    <search><form role="search">…</form></search>
  </header>
  <main>
    <article>
      <header>
        <h1>Título del post</h1>
        <p>Por <a href="/autor/ana">Ana Pérez</a> ·
          <time datetime="2026-10-01">1 de octubre de 2026</time></p>
      </header>
      <section aria-labelledby="precios">
        <h2 id="precios">Precios</h2>
        …
      </section>
      <footer>Sobre la autora…</footer>
    </article>
  </main>
  <aside aria-label="Artículos relacionados">…</aside>
  <footer>Aviso legal · Cookies</footer>
</body>
Encabezados: la tabla de contenidos que leen todos
Los encabezados son lo primero que usan los usuarios de lectores de pantalla para moverse por una página, y lo primero que usan muchos sistemas de IA para trocearla. Tres reglas:
- Un H1 que describa la página, H2 para los apartados y H3 para lo que cuelga de ellos, sin saltarte niveles.
- Nada de encabezados por estética. Si el título de un bloque del menú o el "Suscríbete" de la newsletter es un H2, estás metiendo ruido en el índice de la página. Es exactamente el fallo de W3Schools y de la agencia de la auditoría.
- Olvida el "outline" de HTML5. La idea de que cada
<section>reinicia la jerarquía y admite su propio H1 nunca la implementó ningún navegador, y el WHATWG la retiró de la especificación en 2022. Un H1 dentro de un<section>sigue siendo un H1.
¿Y los H1 múltiples? Google ha dicho que no penalizan. Aun así, recomiendo uno: es lo que espera un usuario de lector de pantalla y lo que facilita a un extractor o a un agente saber de qué va la página.
Texto con significado
Aquí están los errores más finos, los que distinguen a quien conoce la especificación:
<strong>marca importancia y<em>, énfasis.<b>e<i>solo cambian el aspecto.<blockquote>es una cita larga, conciteapuntando a la fuente. Y<cite>es el título de una obra, no el nombre de una persona:<cite>El Quijote</cite>, no<cite>Cervantes</cite>.<time datetime="2026-10-01">convierte una fecha escrita para humanos en una fecha legible para máquinas. Debe coincidir con ladatePublishedde tu Schema.<address>es la información de contacto del autor o del dueño de la página, no cualquier dirección postal que aparezca en el texto.<abbr title="Generative Engine Optimization">GEO</abbr>explica siglas.<dfn>marca el término que se está definiendo, muy útil en párrafos de definición.<code>,<pre>y<kbd>para código, bloques preformateados y teclas.
Listas y tablas
<ul> para listas sin orden, <ol> para pasos y rankings, y <dl> (lista de descripción) para pares término-definición: glosarios, fichas técnicas, especificaciones de producto. Esta última está infrautilizada y es de lo más fácil de extraer que existe.
Las tablas, para datos tabulares y nada más. Con <caption>, <thead> y <th scope="col">. Según el WebAIM Million 2026, solo el 19% de las tablas que encontraron tenían un marcado de tabla de datos válido. Y ya has visto en el experimento lo que le pasa a una tabla hecha con divs cuando la lee una máquina.
<table>
  <caption>Precio orientativo instalado</caption>
  <thead>
    <tr><th scope="col">Material</th><th scope="col">Precio/m²</th></tr>
  </thead>
  <tbody>
    <tr><td>Resina epoxi</td><td>35–60 €</td></tr>
  </tbody>
</table>
Imágenes y multimedia
El alt describe la función de la imagen, no su aspecto literal. Si es decorativa, alt="" vacío (no ausente). Para imágenes con pie, <figure> y <figcaption>, que además asocian el texto a la imagen de forma inequívoca. En el WebAIM Million 2026, el 16,2% de las imágenes no tenía texto alternativo y otro 10,8% lo tenía pero era inútil ("imagen", "foto", el nombre del fichero).
Interacción: enlaces, botones y formularios
La regla es sencilla: <a href> para ir a otro sitio, <button> para hacer algo en la página. Todo lo demás (<div> o <span> con eventos de clic) es invisible para Googlebot como enlace y ambiguo para un agente como control.
<!-- Mal: ni enlace rastreable ni botón accesible -->
<div class="btn" onclick="addToCart(42)">Añadir al carrito</div>

<!-- Bien: el navegador ya sabe que es un botón,
     es enfocable con teclado y aparece en el árbol de accesibilidad -->
<button type="button" onclick="addToCart(42)">Añadir al carrito</button>
En formularios, cada campo con su <label>: un tercio de los campos de las home analizadas por WebAIM no lo tenía. Y para acordeones de preguntas frecuentes, <details> y <summary> funcionan sin JavaScript y el texto está en el HTML desde el principio.
HTML semántico y SEO: lo que Google dice y lo que no
Seamos precisos, porque aquí hay mucho mito:
- No es un factor de ranking directo. Lo ha dicho Google varias veces. Cambiar tus
<div>por<section>no te va a subir posiciones. - Sí influye en cosas que afectan al ranking. Google solo sigue enlaces
<a href>, usa los encabezados para entender de qué trata cada apartado, extrae listas y tablas para los fragmentos destacados y usa elaltpara Google Imágenes. - Dos H1 no penalizan. Otra cosa es que te convenga.
- Schema no sustituye al HTML semántico. Son capas distintas: el HTML describe la página y Schema describe las entidades. Lo ideal es que cuenten la misma historia, por ejemplo con la misma fecha en
<time>y endatePublished.
HTML semántico y GEO: por qué pesa más en la búsqueda con IA
Si en SEO clásico el HTML semántico era higiene, en GEO es infraestructura. Cinco motivos:
1. Lo que no está en el HTML del servidor no existe para la IA
Con los crawlers de IA sin ejecutar JavaScript, el renderizado en servidor (SSR) o la generación estática dejan de ser una preferencia técnica. Si tu web es una SPA que pinta el contenido en el navegador, el HTML semántico perfecto que ves en el inspector de Chrome no le llega a GPTBot.
2. Los encabezados son las costuras por donde se corta tu contenido
Los sistemas de respuesta no citan páginas enteras: citan fragmentos. Muchos pipelines de RAG trocean el texto por encabezados (librerías como LangChain traen un divisor por encabezados Markdown). Si tus H2 no sobreviven a la extracción, como en las versiones B y C del experimento, tu artículo se trocea a ciegas. Y si sobreviven, cada apartado tiene que poder entenderse solo: empieza con la respuesta en la primera frase, sin "como vimos antes".
3. Las tablas y las listas llegan intactas; los divs llegan a trozos
Una comparativa bien marcada es de lo más citable que puedes publicar, porque el modelo recibe la relación entre datos ya hecha. Una comparativa en divs le llega como una columna de valores sueltos.
4. Los agentes necesitan saber qué es un botón (y aquí ARIA no es la primera respuesta)
OpenAI recomienda seguir las buenas prácticas de WAI-ARIA para que Atlas entienda tus controles. Cuidado con leerlo como "añade ARIA a todo". La primera regla del documento del W3C sobre uso de ARIA dice que, si existe un elemento HTML nativo con el significado y el comportamiento que necesitas, uses ese elemento. Especialistas en accesibilidad como Adrian Roselli criticaron precisamente que el mensaje de OpenAI empuje a poner ARIA encima de un HTML mal hecho.
Los datos les dan la razón: en el WebAIM Million 2026, las páginas con ARIA tenían de media 59,1 errores de accesibilidad frente a 42 las que no lo usaban. Mi criterio: HTML nativo para el 90% de los casos y ARIA solo para componentes sin equivalente nativo, como pestañas o combobox, y siguiendo los patrones del W3C al pie de la letra.
5. Semántica y Schema: dos capas que se refuerzan
El HTML dice "este bloque es el artículo principal y esta es su fecha". El Schema dice "este Article lo escribió esta Person, con estas credenciales, y trata de esta entidad". Cuando las dos capas coinciden, el sistema que lee tu página tiene menos que adivinar. Es la misma lógica que explicamos en E-E-A-T para LLMs: consistencia de señales.
Accesibilidad: además, es obligatorio
Desde el 28 de junio de 2025 se aplican las obligaciones del Acta Europea de Accesibilidad, que España transpuso con la Ley 11/2023. Afecta, entre otros, a los servicios de comercio electrónico dirigidos a consumidores, con una exención para microempresas de servicios. No soy abogado y cada caso tiene sus matices, pero el mensaje práctico es claro: la accesibilidad web ya no es voluntaria para muchas tiendas online.
Y el punto de partida en español no es bueno. En el WebAIM Million 2026, las páginas en español tenían de media 64,3 errores detectables, un 14,7% más que la media global. Por plataforma de ecommerce, las home en PrestaShop promediaban 143,2 errores, las de Shopify 75,1 y las de Magento 75,8.
El HTML semántico no resuelve todo (el contraste de color, por ejemplo, es cosa del diseño), pero ataca de raíz cuatro de los seis errores más frecuentes del informe: imágenes sin alternativa, campos sin etiqueta, enlaces vacíos y botones vacíos. Si además declaras el idioma con <html lang="es">, cinco de seis.
Cómo auditar tu HTML semántico en 15 minutos
- Mira lo que devuelve el servidor. Abre el código fuente (Ctrl+U, no el inspector) y busca una frase de tu artículo. Si no está, los crawlers de IA no la ven.
- Prueba el modo lectura de Firefox. Usa el mismo algoritmo (Readability) que muchas herramientas de extracción. Si no muestra tu artículo limpio, con sus apartados, tienes un problema de marcado.
- Revisa encabezados, enlaces y botones con el script de abajo.
- Abre el árbol de accesibilidad en Chrome DevTools (pestaña Elements, panel Accessibility). Así es como te ve un agente.
- Pasa Lighthouse y WAVE para lo que se automatiza:
alt,label,lang, contraste. - Audita la plantilla, no solo el post. Menú, barra lateral y pie. Es donde estaban casi todos los fallos de la auditoría.
Pega esto en la consola del navegador (F12) con tu página abierta:
// Radiografía rápida de HTML semántico
const hs = [...document.querySelectorAll('h1,h2,h3,h4,h5,h6')];
console.table(hs.map(h => ({ nivel: h.tagName, texto: h.textContent.trim().slice(0, 70) })));
let prev = 0;
hs.forEach(h => {
  const n = +h.tagName[1];
  if (prev && n > prev + 1) console.warn('Salto de nivel:', h.tagName, h.textContent.trim());
  prev = n;
});
const badLinks = [...document.querySelectorAll('a')].filter(a => {
  const href = a.getAttribute('href');
  return !href || href === '#' || href.startsWith('javascript:');
});
console.log('H1:', document.querySelectorAll('h1').length,
  '| main:', document.querySelectorAll('main').length,
  '| enlaces sin href válido:', badLinks.length,
  '| div/span con onclick:', document.querySelectorAll('div[onclick],span[onclick]').length,
  '| imágenes sin alt:', document.querySelectorAll('img:not([alt])').length,
  '| lang:', document.documentElement.lang || 'NO DECLARADO');
Un aviso: el contador de onclick solo detecta eventos escritos en el HTML. Los frameworks suelen añadir los clics desde JavaScript, así que un cero ahí no garantiza nada. Para eso está el paso 4.
Los errores que más se repiten
<div>o<span>que hacen de enlace o de botón.- Encabezados usados por tamaño de letra, sobre todo en menús, widgets y pies.
- Página sin
<main>o con varios. <section>por todas partes, sin encabezado, como sustituto de<div>.- Tablas maquetadas con divs y, al revés, divs maquetados con tablas.
- ARIA redundante encima de elementos nativos, como un
<button role="button">. - Contenido que solo aparece tras ejecutar JavaScript.
<cite>para nombres de persona yalt="imagen"en todas las fotos.
Preguntas frecuentes sobre HTML semántico
¿Qué es el HTML semántico?
El HTML semántico es la práctica de usar cada etiqueta según su significado (nav para la navegación, h2 para un apartado, button para un botón, table para datos) en lugar de cajas genéricas como div. Así navegadores, buscadores, lectores de pantalla y sistemas de IA entienden la función de cada parte de la página sin tener que adivinarla.
¿Cuáles son las principales etiquetas semánticas de HTML5?
Las de estructura son header, nav, main, article, section, aside y footer, más search, añadida en 2023. A ellas se suman etiquetas semánticas de siempre: h1 a h6, p, ul, ol, dl, table, figure, time, strong, em, blockquote, a y button.
¿El HTML semántico mejora el posicionamiento en Google?
No es un factor de ranking directo, y Google lo ha dicho varias veces. Sí influye de forma indirecta: Google solo sigue enlaces a con href, usa los encabezados para entender los apartados, extrae listas y tablas para los fragmentos destacados y lee el texto alternativo de las imágenes.
¿Qué diferencia hay entre section y article?
Article es una pieza que tiene sentido por sí sola fuera de la página: un post, una ficha de producto, un comentario. Section es un apartado temático dentro de algo mayor y debería llevar su propio encabezado. Si dudas, pregúntate si ese bloque podría publicarse tal cual en otra web.
¿Qué diferencia hay entre div y section?
Div no significa nada: es un contenedor para agrupar o dar estilo. Section indica un apartado temático con título. Si solo necesitas una caja para el CSS, usa div. Convertir todos los div en section no añade semántica, añade ruido.
¿Puede una página tener más de un H1?
Técnicamente sí, y Google ha dicho que no penaliza. Aun así es mejor un único H1 que describa la página: es lo que esperan los usuarios de lectores de pantalla y lo que facilita a extractores y agentes de IA identificar el tema principal.
¿Afecta el HTML semántico a ChatGPT y a otras IA?
Sí, aunque ninguna publica su pipeline completo. Los crawlers de IA analizados por Vercel no ejecutaban JavaScript, los extractores de texto usan las etiquetas para separar contenido de menús y ChatGPT Atlas navega con el árbol de accesibilidad. En nuestro experimento, solo la versión semántica conservó encabezados y tablas tras la extracción.
¿El HTML semántico es lo mismo que Schema?
No. El HTML semántico describe la función de cada bloque de la página. Los datos estructurados de Schema, normalmente en JSON-LD, describen entidades y sus propiedades, como el autor, la fecha o el precio. Son complementarios y conviene que cuenten la misma historia.
Conclusión
El HTML semántico no te va a subir posiciones por sí solo, y quien te diga lo contrario te está vendiendo humo. Lo que sí hace es decidir cómo llega tu contenido a todo lo que no es un humano delante de una pantalla: el crawler que no ejecuta JavaScript, el extractor que decide qué es menú, el sistema que trocea tu artículo por encabezados y el agente que tiene que encontrar tu botón de compra.
En 2026, esos lectores ya son la mayoría. Y como has visto en la auditoría, ni siquiera las páginas que enseñan HTML semántico lo aplican en su plantilla. Ahí hay una ventaja fácil de coger.
En LLMFY analizamos las señales que usan los sistemas de IA para decidir a quién citar: con el Schema Scan revisas tus datos estructurados y con el Robots.txt Optimizer compruebas qué crawlers de IA pueden entrar en tu web. Analiza tu URL gratis y mira por dónde cojea.
Fuentes y referencias
- WHATWG — HTML Living Standard — Especificación oficial de HTML.
- MDN Web Docs — Semántica — Definición y ejemplos.
- Google Search Central — Prácticas recomendadas sobre enlaces — Qué enlaces puede rastrear Google.
- Search Engine Journal — Semantic HTML: Not A Ranking Factor But Still Important — Declaraciones de John Mueller (2023).
- Search Engine Journal — Google Answers Question About The Impact Of ARTICLE Semantic HTML Element — Mueller sobre la etiqueta article.
- Vercel y MERJ — The rise of the AI crawler — Comportamiento de los crawlers de IA con JavaScript (diciembre de 2024).
- Penedo et al., Hugging Face — The FineWeb Datasets — Extracción de texto con trafilatura para entrenar LLMs.
- WebAIM — The WebAIM Million 2026 — Accesibilidad del millón de páginas de inicio más visitadas.
- W3C — Using ARIA — Las reglas de uso de ARIA.
- Search Engine Journal — How AI Agents See Your Website — Cómo leen la web Atlas, Playwright MCP y otros agentes.
- Adrian Roselli — OpenAI, ARIA, and SEO: Making the Web Worse — Crítica a la recomendación de ARIA de OpenAI.
- EUR-Lex — Directiva (UE) 2019/882 — Acta Europea de Accesibilidad, transpuesta en España por la Ley 11/2023.
- LLMFY — Schema para LLMs, SEO semántico e Information gain — Guías relacionadas.